Building an Event-Driven AWS Pipeline with LocalStack & Terraform
Overview
Diprojek kali ini saya akan mendemonstrasikan cara membuat sebuah system event driven pipeline Aws tapi menggunakan Localstack karena saya tidak punya uang untuk sewa aws jadinya saya memutar otak mencari cara bagaimana saya bisa belajar aws tanpa mengeluarkan uang sepeserpun,localstack ini hanya mock api dari aws jadi untuk resouce aws asli sepeerti ec2 itu tidak bisa di buat dan bukan sebuah node asli dan postingan projek ini hanya berupa langkah awal atau step 1 dari sebuah projek yang cukup rumit menurut saya.Projek berikutnya mengganti semua resource yang tidak bisa digunakan seperti ec2 karena localstack hanya mock api dari aws jadinya tidak ada node asli,lalu eks,cloudwatch,dll.Semua resource yang tidak bisa berjalan seperti service aws asli akan diganti dengan tools opensource yang memiliki kegunaan yang sama seperti ec2 dengan KVM/QEMU,lalu observ tools dengan plg stack dan container orchestration eks dengan kubernetes asli,langsung saja masuk ke pembahasan.
Structure Folder
terraform-setup/
├── aws.tf
├── s3.tf
├── sns.tf
├── sqs.tf
├── sqs-trigger-lambda.tf
├── iam-attachment-role.tf
├── iam-attachment-role-consumer.tf
├── lambda_function_consumer.py
├── lambda_function.py
├── lambda-permission.tf
├── lambda.tf
├── lambda-2.tf
├── cloud-watch.tf
├── cloud-watch-metrics.tf
├── dynamodb.tf
Tools
- Wsl : v0.2.1
- Terraform : v1.15.8
- Localstack : v2026.6.3
- Docker : v29.1.3
- Python : v3.12.3
- Aws Cli : v1.45.52
Reasoning
Kenapa saya mengerjakan projek ini terlebih dahulu?? karena ini merupakan alur pembelajaran jadinya saya bisa belajar service-service aws terlebih dahulu tidak langsung masuk ke projek yang sesungguhnya saya harus belajar daulu dari awal.
Setup
Oke masuk ke bagian setup dari projek ini masuk ke web dari localstack lalu sign in
jika sudah sign in menggunakan akun google maka akan di bawa ke sebuah dashboard seperti ini
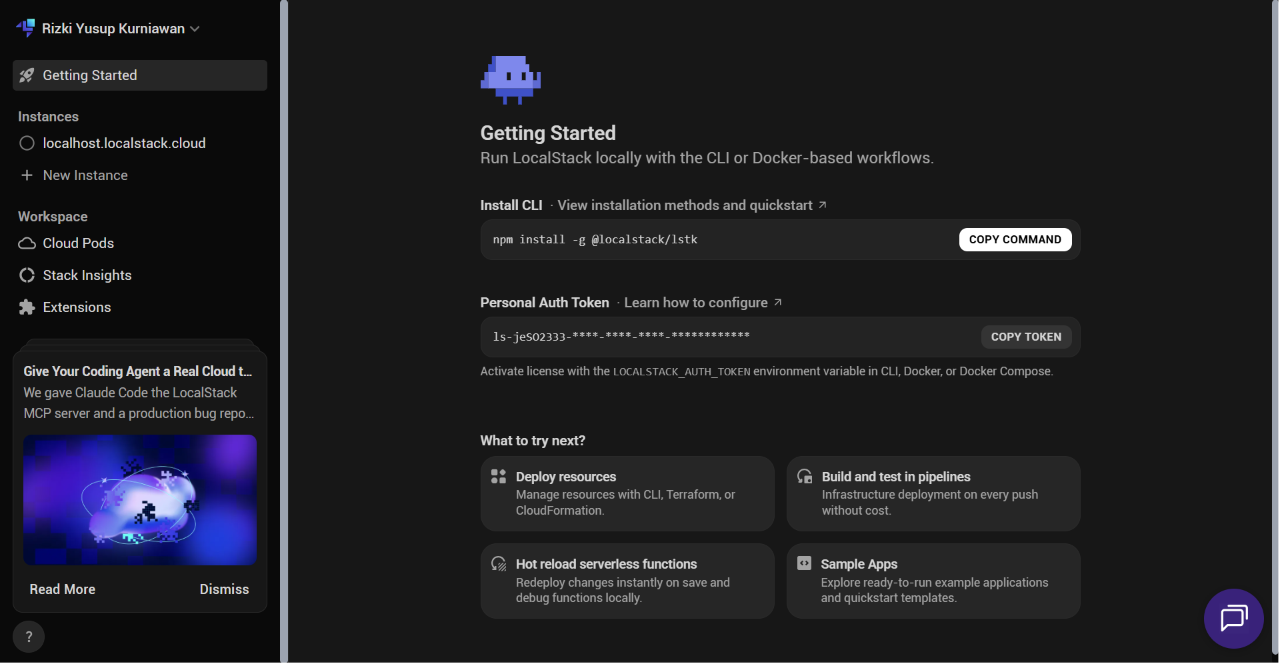
oke jika sudah maka akan keluar tampilan dari token nah token ini yang akan digunakan untuk menjalankan container localstak nantinya, jika sudah buka terminal lalu masuk ke wsl,jika belum ada docker install terlebuih dahulu docker,lalu run command ini untuk menjalankan container
docker run -d --name localstack   -e LOCALSTACK_AUTH_TOKEN=TOKE-AUTH  -e PERSISTENCE=1   -e LAMBDA_DOCKER_NETWORK=bridge   -e
LOCALSTACK_HOST=localhost.localstack.cloud   -p 4566:4566   -p 4510-4559:4510-4559   -v ~/localstack-data:/var/lib/localstack   -v
/var/run/docker.sock:/var/run/docker.sock   localstack/localstack
oke jika sudah maka selamat localstack berjalan di wsl,berikutnya yaitu setup aws cli dan aws rapper,gunakan command
pip install awscli --break-system-packages
untuk aws wrappernya agar nantinya tidak perlu menambahkan endpoint url di setiap command,gunakan command ini untuk install aws wrapper nya
pip install awscli-local --break-system-packages
lalu jika sudah export path dari aws cli ke bashrc karena terinstall di folder bin local bukan di sistem jadinya perlu export path dari file local ke sistem
echo 'export PATH="$HOME/.local/bin:$PATH"' >> ~/.bashrc
source ~/.bashrc
lalu jika sudah maka bisa test langsung buat sebuah bucket pertama untuk testting saja,gunakan command
awslocal s3 mb s3://test1-bucket
jika sudah berhasil periksa apakah bucket sudah dibuat
awslocal s3 ls
jika sudah keluar sebuah output yaitu bucket yang tadi sudah dibuat maka setup aws cli dan aws wrapper sudah selesai sekarang. oke sudah selesai dengan setup aws masuk ke step berikutnya yaitu setup dari terraform,tinggal install terraform saja sih,masuk ke website ini ,oke jika bagian install terraform selesai maka tinggal testting saja buat sebuah file config untuk connect dengan provider aws agar terraform bisa berjalan
vim aws.tf
|
provider "aws" {
  access_key                  = "test"
  secret_key                  = "test"
  region                      = "us-east-1"

  s3_use_path_style           = true
  skip_credentials_validation = true
  skip_requesting_account_id  = true
  skip_metadata_api_check     = true

  endpoints {
    s3  = "http://localhost:4566"
    iam = "http://localhost:4566"
    sts = "http://localhost:4566"
    sqs = "http://localhost:4566"
    sns = "http://localhost:4566"
    dynamodb = "http://localhost:4566"
    lambda = "http://localhost:4566"
    logs = "http://localhost:4566"
    cloudwatch = "http://localhost:4566"
  }
}
oke untuk credentials skip karena ini hanya simulasi dari aws dan bukan aws asli yang memerlukan credentials akun aws jadinya perlu di ingat bahwa tidak menggunakan credentials,lalu baris berikutnya requesting account id sama seperti credentials yaitu agar terraform tidak menanyakan id account asli dari aws jadinya tidak ada error yang akan muncul kedepannya,lalu skip metadata api agar terraform tidak mencoba untuk mengambil meta data asli dari aws dan karena ini bukan aws asli jadinya skip saja, oke untuk teralhir itu semua adalah service yang akan digunakan dan tentunya service ini berjalan dan asli bukan seperti ec2,eks,dll.Service-service diatas bisa berfungsi selayaknya sebuah service di aws,jika sudah coba untuk connect dengan menggunakan command
terraform init
jika suda dan keluar output seperti ini
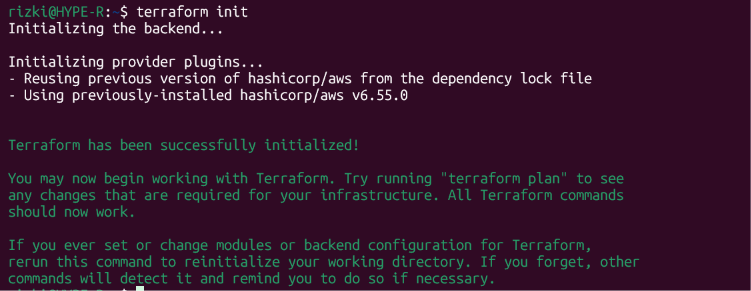
oke jika sudah maka akan keluar output hijau seperti diatas,jika sudah melakukan init dan berhasil lanjut ke tahap selanjutnya yaitu pembuatan resource dan service aws dengan menggunakan terraform sebagai provisioning tools,semua config yang akan di buat saya ambil dari docs di terraform aws provider docs oke jika sudah masuk config pertama yaitu pembuatan s3 bucket
vim s3.tf
|
resource "aws_s3_bucket" "test-bucket" {
  bucket = "my-tf-test-bucket"
}
oke config pertama yaitu pembuatan s3 karena nanti di workflow akan dibutuhkan s3 makanya s3 bucket di buat terlebih dahulu,masuk ke config selannjutnya,yaitu config untuk role dan karena role ini di tujukan untuk lambda dan di dalam workflow nya ada 2 lambda nanti lambda producer dan lambda consumer,jadinya role untuk lambda producer terlebuh dahulu
vim iam-attachment-role.tf
|
data "aws_iam_policy_document" "assume_role" {
  statement {
    effect = "Allow"

    principals {
      type        = "Service"
      identifiers = ["lambda.amazonaws.com"]
    }

    actions = ["sts:AssumeRole"]
  }
}

resource "aws_iam_role" "role" {
  name               = "role-lambda"
  assume_role_policy = data.aws_iam_policy_document.assume_role.json
}

data "aws_iam_policy_document" "lambda-policy" {
  statement {
    effect    = "Allow"
    actions   = [ "s3:GetObject", "sns:Publish","logs:CreateLogGroup", "logs:CreateLogStream", "logs:PutLogEvents"]
    resources = ["*"]
  }
}

resource "aws_iam_policy" "Lambda-role-policy" {
  name        = "role-lambda-policy"
  description = "A Lambda policy"
  policy      = data.aws_iam_policy_document.lambda-policy.json
}

resource "aws_iam_role_policy_attachment" "test-attach" {
  role       = aws_iam_role.role.name
  policy_arn = aws_iam_policy.Lambda-role-policy.arn
}
oke diatas merupakan config untuk role lambda producer, di bagian paling atas menyatakan bahwa role ini hanya bole di pinjam oleh service lambda,lalu masuk ke bagian ke dua yaitu pembuatan role lambda dan juga role lambda akan diarahakan ke assume role ynag sebelumnya dibuat,setelah itu bagian ketiga, yaitu pembuatan policy di bagian ini khusus menentukan apa yang bisa dilakukan ole lambda,dengan policy ini lambda di berikan akses seperti s3 untuk melihat detail objek,lalu sns untuk publish message,dll.Pada bagian selanjutnya yaitu bagian empat pembuatan policy dan policy diarahkan ke data policy sebelumnya,dan yang terakhir yaitu menempelkan role ke policy yang sudah dibuat, oke masuk ke file config selanjutnya yaitu file role lambda consumer
vim iam-attachment-role-consumer.tf
|
data "aws_iam_policy_document" "lambda-consumer-assume-role" {
  statement {
    effect = "Allow"

    principals {
      type        = "Service"
      identifiers = ["lambda.amazonaws.com"]
    }

    actions = ["sts:AssumeRole"]
  }
}

resource "aws_iam_role" "lambda-consumer-role" {
  name               = "lamda-consumer-role"
  assume_role_policy = data.aws_iam_policy_document.lambda-consumer-assume-role.json
}

data "aws_iam_policy_document" "lambda-consumer-policy" {
  statement {
    effect    = "Allow"
    actions   = [  "sqs:ReceiveMessage", "sqs:DeleteMessage",
    "dynamodb:PutItem", "dynamodb:UpdateItem",
    "logs:CreateLogGroup", "logs:CreateLogStream", "logs:PutLogEvents"]
    resources = ["*"]
  }
}

resource "aws_iam_policy" "Lambda-role-consumer-policy" {
  name        = "lambda-consumer-role-policy"
  description = "A Lambda policy"
  policy      = data.aws_iam_policy_document.lambda-consumer-policy.json
}

resource "aws_iam_role_policy_attachment" "lambda-consumer-role-attachment" {
  role       = aws_iam_role.lambda-consumer-role.name
  policy_arn = aws_iam_policy.Lambda-role-consumer-policy.arn

}
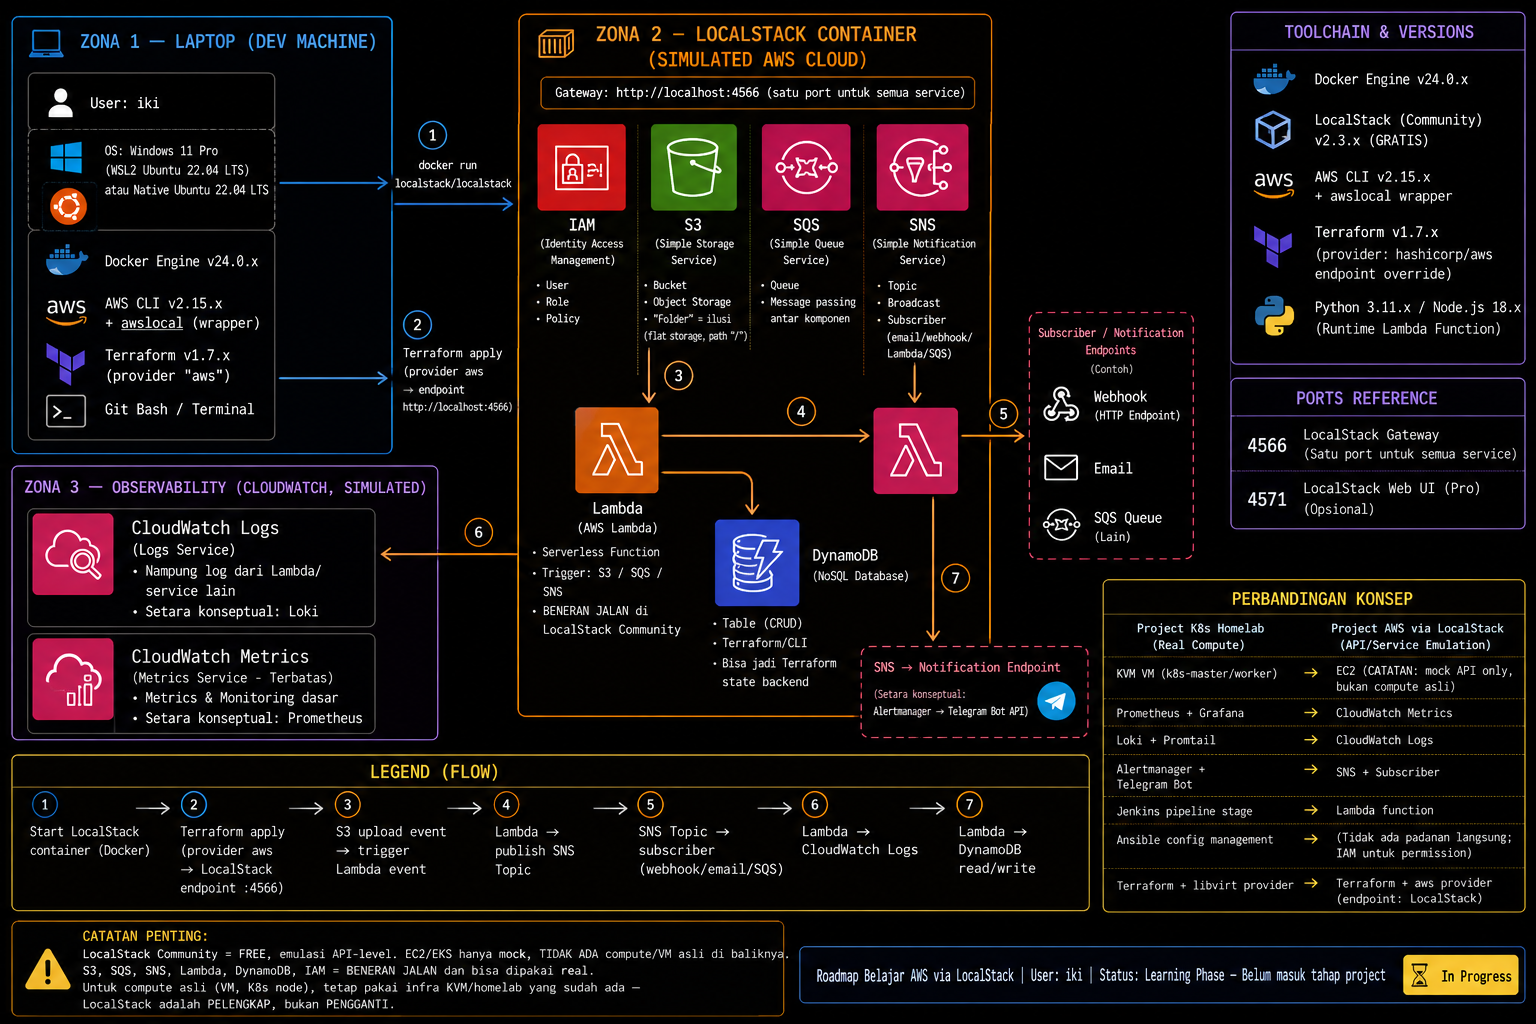
oke sama seperti penjelasan file role lambda prodycer,di file role lambda consumer kurang lebih struktur filenya sama yang membedakannya hanyalah policy yang diberikan, mengacu pada workflow nantinya sistem akan bekerja dengan cara event s3 -> lambda (producer/lambda pertama) -> sns (publish) -> sqs -> lambda (consumer/lambda kedua),kurang lebih seperti ini gambaran dari sistem yang sedang dibuat nantinya diakhir ada cloud watch dan dynamodb sebagai pelengkap dan juga alert ke telegram (bot),oke karena ini lambda kedua atau lambda consumer policy yang di berikan juga cukup berbeda dengan lambda pertama atau producer,seperti sqs recieve message,lalu ada update dynamodb,dll. Jika semua policy dan role yang diburuhkan masing masing lambda sudaha ada bisa lanjut ke file config selanjutnya,file selanjutnya yaitu sns terlebih dahulu
vim sns.tf
|
resource "aws_sns_topic" "user_updates" {
  name = "user-updates-topic"
}
resource "aws_sns_topic_subscription" "user_updates_sqs_target" {
  topic_arn = aws_sns_topic.user_updates.arn
  protocol  = "sqs"
  endpoint  = aws_sqs_queue.user-sqs.arn
}
untuk file config sns standar saja saya ambil dari docs terraform,oke lanjut ke sqs
vim sqs.tf
|
resource "aws_sqs_queue" "user-sqs" {
  name = "pentil_kuda"
  provider = aws
}

resource "aws_sqs_queue_policy" "example" {
  queue_url = aws_sqs_queue.user-sqs.id

  policy = jsonencode({
    Version = "2012-10-17"
    Statement = [{
      Sid    = "Cejuwdam"
      Effect = "Allow"
      Principal = {
        Service = "sns.amazonaws.com"
      }
      Action   = "SQS:SendMessage"
      Resource = aws_sqs_queue.user-sqs.arn
      Condition = {
        ArnLike = {
          "aws:SourceArn" = aws_sns_topic.user_updates.arn
        }
      }
    }]
  })
}
untuk config sqs kurang lebih seperti ini,di config diatas bagian pertama yaitu membuat resource sqs lalu setelah itu membuat policy untuk sqs ini dan diarahkan ke resource sqs tadi,masuk ke configurasi selanjutnya yaitu bagian cloudwatch,
vim cloud-watch.tf
|
resource "aws_cloudwatch_log_group" "test" {
  name = "/aws/lambda/lambda_function_consumer"
  retention_in_days = 5
  tags = {
    Environment = "production"
    Application = "serviceA"
  }
}
untuk cloud watch log grop pastikan nama sesuai dengan lambda function consumer karena lambda consumer lah yang akan di simpan lognya,next ke cloud watch metrics alarm sebelum masuk ke bagian config run terlebih dahulu command ini
awslocal cloudwatch list-metrics
command diatas akan menampilkan jumlah metrics yang tersedia
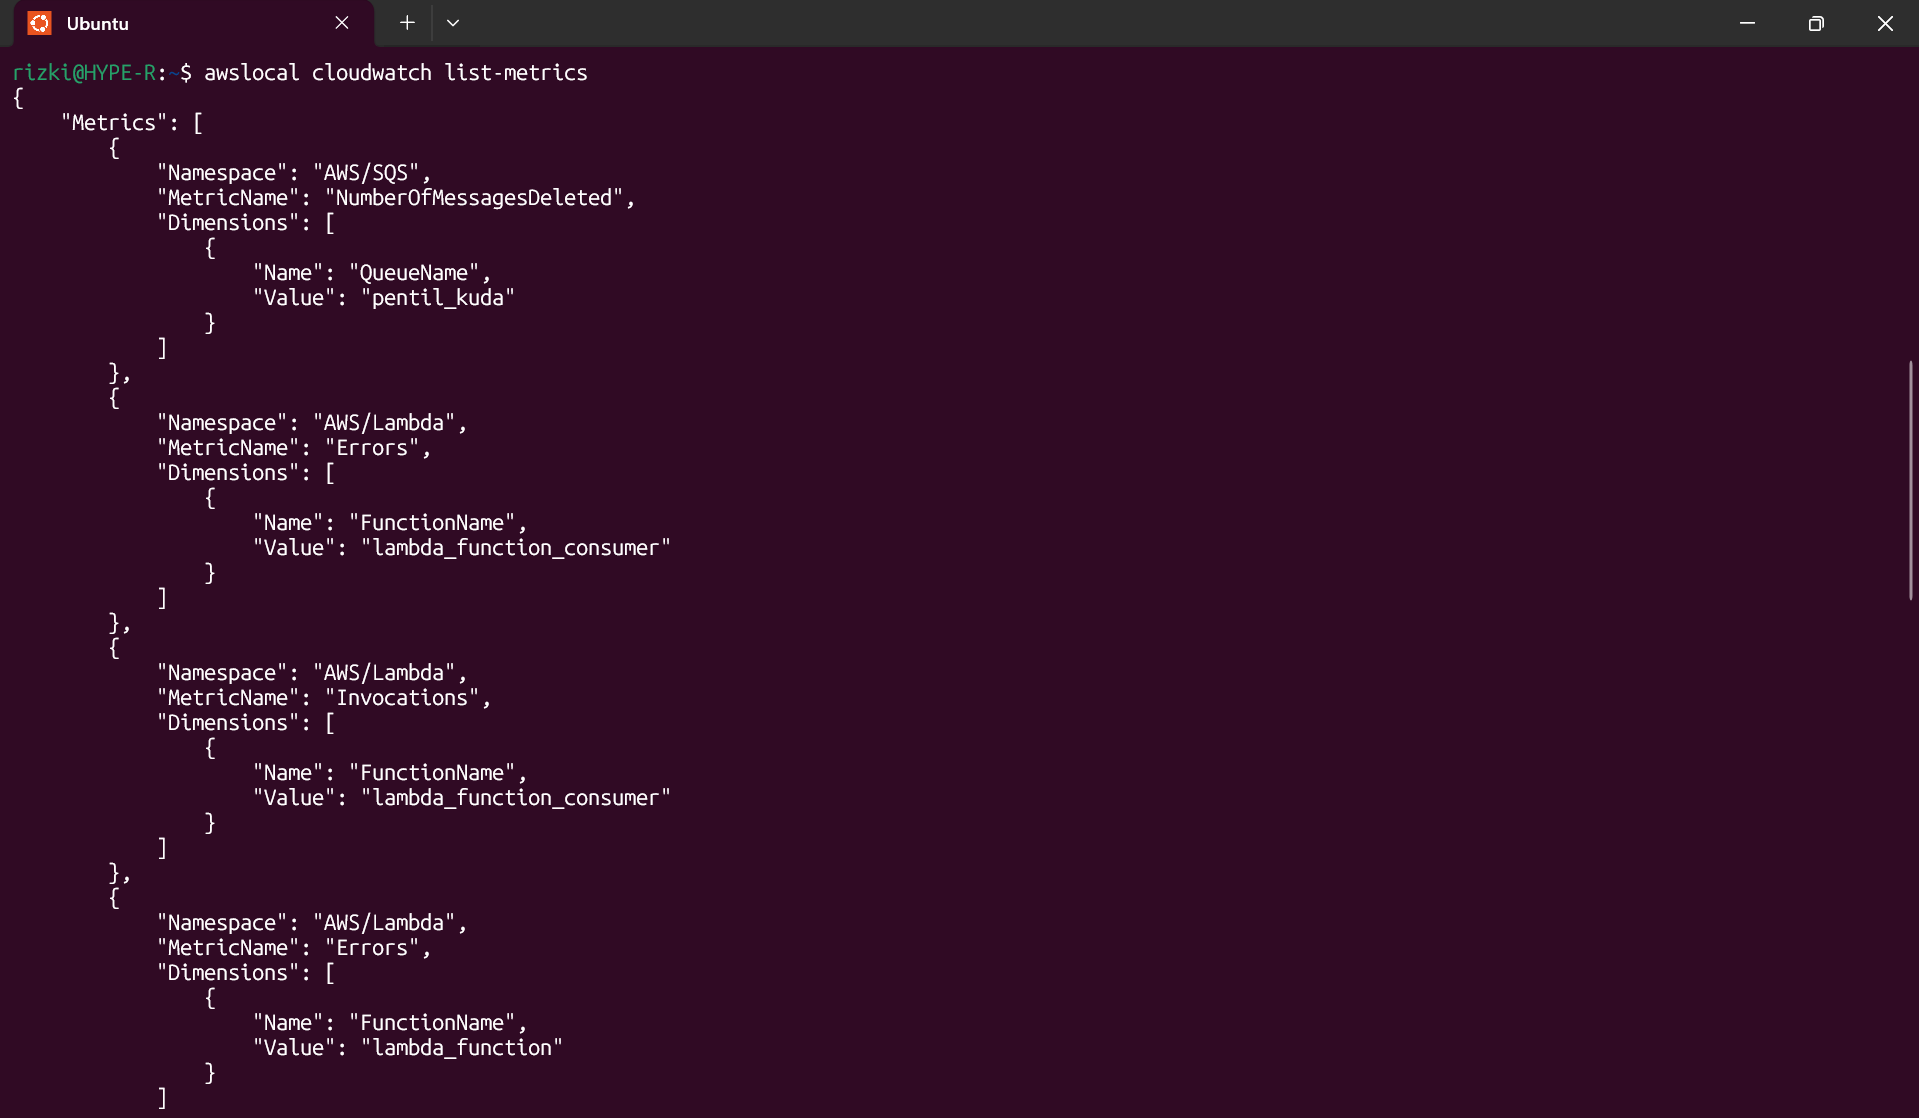
pilih metrics sesuai dengan output yang ada,jangan sampai memilih metrics yang tidak ada,oke next masuk ke config cloud watch metrics
vim cloud-watch-metrics.tf
|
rizki@HYPE-R:~$ cat cloud-watch-metrics.tf
resource "aws_cloudwatch_metric_alarm" "test" {
  alarm_name                = "terraform-test"
  comparison_operator       = "GreaterThanOrEqualToThreshold"
  evaluation_periods        = 2
  metric_name               = "Errors"
  namespace                 = "AWS/Lambda"
  period                    = 120
  statistic                 = "Average"
  threshold                 = 80
  alarm_description         = "This metric monitors Lambda"
  dimensions = {
    FunctionName = "lambda_function_name"
  }

  insufficient_data_actions = []
}
oke saya menggunakan metrics Errors untuk name space AWS/Lambda,ingat harus sesuai denga yang ada di output command tadi,lanjut ke lambda function bagian lambda producer atau lambda pertama sebelum masuk ke config lambda mari buat terlebih dahulu code untuk lambda handler dan disni saua menggunakan python sebagai handler
vim lambda_function.py
|
import json
import boto3

sns_client = boto3.client('sns')

TOPIC_ARN = "arn:aws:sns:us-east-1:000000000000:user-updates-topic"

def lambda_handler(event, context):
    record = event['Records'][0]
    bucket_name = record['s3']['bucket']['name']
    object_key = record['s3']['object']['key']

    message = f"File baru diupload: {object_key} ke bucket {bucket_name}"

    sns_client.publish(
        TopicArn=TOPIC_ARN,
        Message=message
    )

    return {
        'statusCode': 200,
        'body': json.dumps('Notifikasi terkirim!')
    }
sebelum masuk ke bagian file config zip terlebih dahulu file python nya
zip lambda_function.zip lambda_function.py
oke jika sudah du zip masuk ke bagian config dari lambda produser atau lambda pertama
vim lambda.tf
|
resource "aws_lambda_function" "lambda-function" {
  filename      = "${path.module}/lambda_function.zip"
  function_name = "lambda_function"
  role          = aws_iam_role.role.arn
  handler       = "lambda_function.lambda_handler"
  source_code_hash = filebase64sha256("${path.module}/lambda_function.zip")

  runtime = "python3.12"

  environment {
    variables = {
      ENVIRONMENT = "production"
      LOG_LEVEL   = "info"
    }
  }

  tags = {
    Environment = "production"
    Application = "example"
  }
}
oke bagian dari config lambda langsung menunjuk ke role yang sudah di siapkan sebelumnya di iam-attachment-role,lalu ada baris untuk menunjukan path ke handler dari si lambda function yang tadi sudah di buat dengan format zip,lalu di bagian bawah ada runtime sesuaikan dengan handler yang sudah di buat jika handler python berarti runtime harus python,masuk ke config selanjutnya yaitu untuk permission agar nantinya lambda bisa notice ada event di s3
vim lambda-permission.tf
|
resource "aws_lambda_permission" "allow_bucket" {
  statement_id  = "AllowExecutionFromS3Bucket"
  action        = "lambda:InvokeFunction"
  function_name = aws_lambda_function.lambda-function.arn
  principal     = "s3.amazonaws.com"
  source_arn    = aws_s3_bucket.test-bucket.arn
}
resource "aws_s3_bucket_notification" "bucket_notification" {
  bucket = aws_s3_bucket.test-bucket.id

  lambda_function {
    lambda_function_arn = aws_lambda_function.lambda-function.arn
    events              = ["s3:ObjectCreated:*"]
    filter_prefix       = "AWSLogs/"
    filter_suffix       = ".log"
  }

  depends_on = [aws_lambda_permission.allow_bucket]
}
dibagian atas akan mengizin kan lambda untuk melakukan aksi ke s3 bucket yang sudah dibuat lalu setiap event akan di filter sesuai dengan jenis atau format file yang masukk ke s3 bucket jadinya lambda hanya akan memproses event yang format file sesuai dengan yang sudah di filter di dalam prefix dan sufix,untuk prefix sendiri itu awal dari nama item atau path file dan pastikan diarahkan ke function producer,masuk ke bagian selanjutnya yaitu lambda consumer atau lambda kedua tapi sebelum itu buat variable terlebih dahulu,variable ini nantinya berisi token bot dan id chat cara untuk mendapatkan token bot bisa dihilat di projek sebelumnya disini,jike sudah masuke bagian id chat dan bot token ke file terraform vars
vim terraform.tfvars
|
telegram_bot_token = "xxxxxx"
telegram_chat_id   = "xxxxxx"
oke jika sudah masuk ke file config lambda ,seperti biasa buat handler terlebih dahulu
vim lambda_function_consumer.py
|
import json
import time
import os
import urllib.request
import urllib.error
import boto3

dynamodb = boto3.resource('dynamodb')
TABLE_NAME = "PipelineHistory"
table = dynamodb.Table(TABLE_NAME)

BOT_TOKEN = os.environ.get('TELEGRAM_BOT_TOKEN')
CHAT_ID = os.environ.get('TELEGRAM_CHAT_ID')


def send_telegram_alert(text):
    if not BOT_TOKEN or not CHAT_ID:
        print("TELEGRAM_BOT_TOKEN atau TELEGRAM_CHAT_ID belum diset, skip alert")
        return

    url = f"https://api.telegram.org/bot{BOT_TOKEN}/sendMessage"
    payload = json.dumps({
        "chat_id": CHAT_ID,
        "text": text
    }).encode('utf-8')

    req = urllib.request.Request(
        url,
        data=payload,
        headers={"Content-Type": "application/json"},
        method="POST"
    )

    try:
        with urllib.request.urlopen(req, timeout=8) as response:
            print(f"Telegram alert terkirim, status: {response.status}")
    except urllib.error.HTTPError as e:
        print(f"Telegram API error: {e.code} - {e.read().decode('utf-8')}")
    except urllib.error.URLError as e:
        print(f"Gagal konek ke Telegram API: {str(e)}")


def lambda_handler(event, context):
    print(f"RAW EVENT: {json.dumps(event)}")

    for record in event['Records']:
        body = json.loads(record['body'])
        original_message = body.get('Message', 'Pesan tidak ditemukan')
        sns_message_id = body.get('MessageId', record.get('messageId', 'unknown'))

        print(f"Pesan diterima dari SQS: {original_message}")

        item = {
            'event_id': sns_message_id,
            'timestamp': int(time.time() * 1000),
            'message': original_message,
            'source': 'sqs-consumer-lambda',
            'status': 'processed',
        }

        try:
            table.put_item(Item=item)
            print(f"Berhasil ditulis ke DynamoDB: {item['event_id']}")
        except Exception as e:
            print(f"GAGAL nulis ke DynamoDB: {str(e)}")

            send_telegram_alert(f"GAGAL nulis history ke DynamoDB!\n{original_message}\nError: {str(e)}")
            raise


        send_telegram_alert(f" Pipeline event diproses:\n{original_message}")

    return {
        'statusCode': 200,
        'body': json.dumps('Pesan berhasil diproses, dicatat ke DynamoDB, dan alert terkirim')
    }
jika sudah zip file handler nya
zip lambda_function_consumer.zip lambda_function_consumer.py
jika sudah masuk ke file config lambda consumer
vim lambda-2.tf
|
resource "aws_lambda_function" "lambda-function-consumer" {
  filename          = "${path.module}/lambda_function_consumer.zip"
  function_name     = "lambda_function_consumer"
  role              = aws_iam_role.lambda-consumer-role.arn
  handler           = "lambda_function_consumer.lambda_handler"
  source_code_hash  = filebase64sha256("${path.module}/lambda_function_consumer.zip")
  runtime           = "python3.12"
  timeout           = 10

  environment {
    variables = {
      TELEGRAM_BOT_TOKEN  = var.telegram_bot_token
      TELEGRAM_CHAT_ID    = var.telegram_chat_id
    }
  }

  tags = {
    Environment = "production"
    Application = "example"
  }
}

variable "telegram_bot_token" {
  type        = string
  sensitive   = true
}

variable "telegram_chat_id" {
  type        = string
  sensitive   = true

}
kurnag lebih sama seperti lambda function yang pertama atau producer di lambda function kedua atau consumer sama saja bagian pertama langsung membuat function dengan menunjukan letak dari handler lambda function consumer yang sebelumnya sudah dibuat lalu arahkan juga ke role consumer yang sudah dibuat,dan ada tambahan untuk bagian bot masukan variable sebelumnya yang sudah ada di file terraform.vars,oke jika sudah selesai masuk ke bagian config dynamodb
vim dynamodb.tf
|
resource "aws_dynamodb_table" "pipeline-history-table" {
  name         = "PipelineHistory"
  billing_mode = "PAY_PER_REQUEST"

  hash_key  = "event_id"
  range_key = "timestamp"

  attribute {
    name = "event_id"
    type = "S"
  }

  attribute {
    name = "timestamp"
    type = "N"
  }

  tags = {
    Name        = "pipeline-history"
    Environment = "learning"
  }
}
oke untuk dynamodb sudha selesai,masuk ke bagian config selanjutnya yaitu sqs trigger lambda
vim sqs-trigger-lambda.tf
|
resource "aws_lambda_event_source_mapping" "sqs-trigger" {
  event_source_arn = aws_sqs_queue.user-sqs.arn
  function_name    = aws_lambda_function.lambda-function-consumer.arn
  batch_size       = 10

  scaling_config {
    maximum_concurrency = 100
  }
}
oke dibagian ini pastikan bahwa function name mengarahken lambda function consumer karena ini bagian config ini khusus untuk lambda consumer,jadi seperti workflow event s3 -> lambda (producer/pertama) -> sns -> sqs -> lambda (consumer/kedua),dan yang terakhir ada lambda nulis di dynamodb dan ada log di cloud watch,oke jika sudah sekarang coba plan terlebih dahulu
terraform plan
jika terraform plan berhasil dan tidak ada error satu pun lanjut apply provisioning
terraform apply
jika sudah ke apply sekarang test buat sebuah file dengan format .log
vim test.log
|
test
oke jika sudah sekarang test event apakah sistem berjalan sesuai dengan yang di harapkan
awslocal s3 cp test.log s3://my-tf-test-bucket/AWSLogs/xxxx.log
oke jika sudah tunggu beberapa saat dan seharus nya ada notifikasi dari telegram
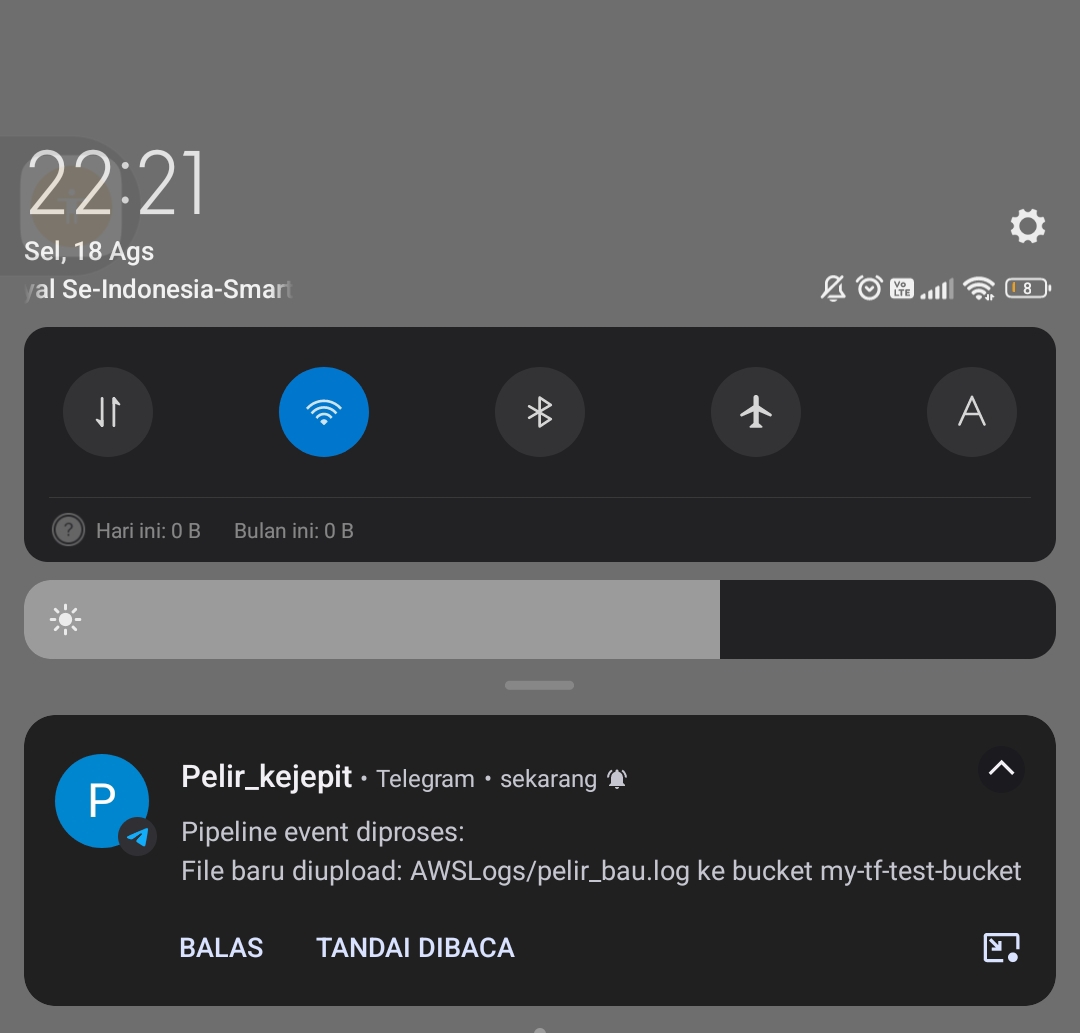
oke sudah berahasil ada notifikasi dari telegram,selanjutnya cek dynamodb apakah lambda benar benar menulis ke dynamodb,gunakan command
awslocal dynamodb list-tables
|
awslocal dynamodb scan --table-name TABLE-NAME <- output dari list-tables
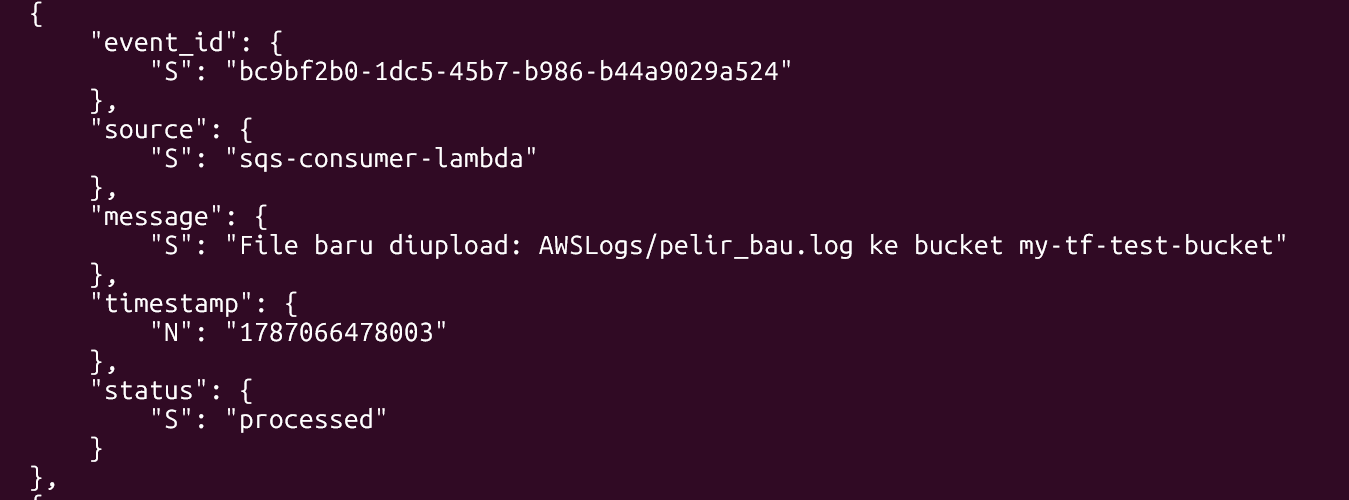
oke sudah selesai notofikasi ada dan data sudah ada di table dynamodb,terimakasih sudah menyimak