Debugging Error Designing a Cross-Platform DevOps Lab: From Provisioning to Production-Grade Observability (K8s, Terraform, Ansible, Prometheus, Loki, Alertmanager)
.png)
Overview
Sampai juga di pembahasan error untuk projek monitoring tools,kali ini saya akan membahas error apa saja yang saya temukan ketika saya mengerjakan projek ini oke langsung saja
Cannot Reach Dashboard Grafana
sesaat setelah selesai melakukan installasi grafana seharusnya langsung akses dashboard dari grafana untuk melakukan visualisasi data tapi karena di gambar workflow infrastructure projek ini memiliki layer yang cukup kompleks jadinya susah untuk di tembus jika saja ingin langsung mengakses dashboard grafana sesaat setelah melakukan installasi maka dari itu jika ingin mengakses dashboard grafana tidak bisa langsung mengaksesnya karena akan terlihat seperti ini
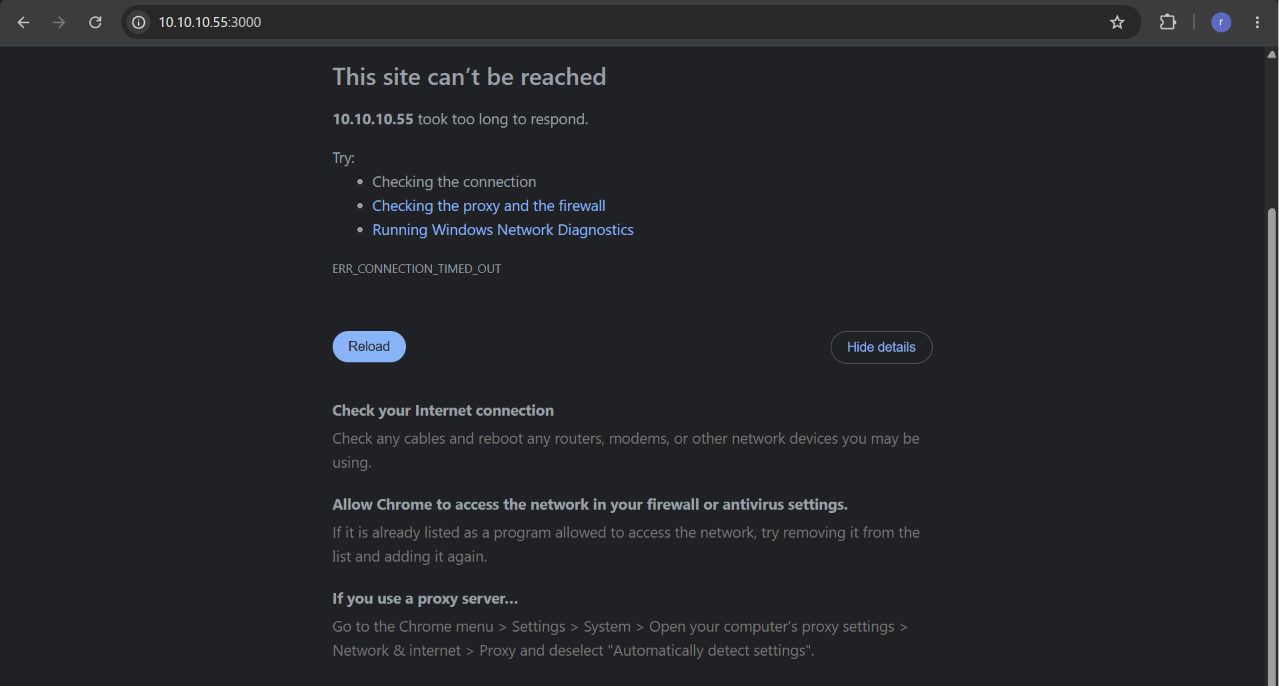
dashboard tidak bisa diakses
Solve
Karena ada beberapa kayer network yang harus di bypass jadinya memerlukan setu tools lagi bernama socat,untuk mengnstallnya bisa di cek di dcos projeknya bisa langsung dilihat di tutorial kalau ingin langsung tinggal copy saja command ini
sudo apt install socet -y
karena socat sudah diinstall langsung saja gunakan command
Di WSL
|
socat TCP-LISTEN:8884,bind=0.0.0.0,fork TCP:ip-node-master:3001 &
dan
DI Node-Master
|
kubectl port-forward svc/prometheus-grafana 3001:80 -n monitoring --address=0.0.0.0 &Forwarding from 0.0.0.0:3001 -> 3000
yahh semua ini sudah ada di docs ini hanya penjelasannya saja kenapa harus menggunakan socat dan melakukan port forward
pod has unbound immediate PersistentVolumeClaims
Error ini akan membuat pods loki tetap pending karena loki mencari sebuah storage class tapi cluster tidak menemukan satupun storage class default,jadinya pods loki akan terus pending dan tidak akan pernah berjalan sebagaimana mestinya
Solve
Jadi karena hanya kurang dengan storagenya tinggal buat saja disini saya menggunakan rancher gunakan command
kubectl apply -f https://raw.githubusercontent.com/rancher/local-path-provisioner/v0.0.30/deploy/local-path-storage.yaml
lalu jadikan storage nya sebagai default
kubectl patch storageclass local-path -p '{"metadata": {"annotations":{"storageclass.kubernetes.io/is-default-class":"true"}}}'
lalu tunggu sampai loki restart atau jika loki belum juga running hapus terlebih dahulu pod loki dan storage lama yang dibuat otomatis
kubectl delete pod loki-0 -n monitoring
|
kubectl delete pvc storage-loki-0 -n monitoring
loki-chunks-cache-0 failed 2 Insufficient memory
erorr loki dimana loki meminta cache yang terlalu besar lebih dari ukuran si node itu sendiri jadinya ada error serprti ini 2 Insufficient memory
Solve
Karena sudah ada root cause dari error ini tinggal eksekusi saja,untuk menyelesaikan error ini cukup hapus saja pods loki yang menyebabkan pending ini karena menyebabkan beban pada node gunakaan command
helm upgrade loki grafana/loki --namespace monitoring --kubeconfig /home/ubuntu/.kube/config --reuse-values --set chunksCache.enabled=false --set resultsCache.enabled=false
dan seharusnya dua pods loki-chunks-cache-0 dan loki-results-cache-0 akan menghillang dan menyisakan pods yang memang penting karena statefulnya sudah di set 0 / podsnya dihapus
Error: repo grafana not found
ini sering terjadi jika akan mengupgrade menggunakan helm dan waktu installasi helm kan meggunakan ansible otomatis user root yang mengeksekusi semua tasknya termasuk installasi dari si helm itu sendiri makanya ketika ingin melakukan upgrade atau apapun yang berhubungan dengan helm akan otomatis bertanya siapa yang melakukan ini dan karena waktu installasi root lah yang melakukan semuanya jadi ketika user biasa mengupgradenya akan keluar error seperti itu
Solve
Untuk error ini cukup sederhana tinggal tambahkan saja repo nya
helm repo add grafana https://grafana.github.io/helm-charts
helm repo update
lalu lakukan helm upgrade lagi deh
Loki Unable to Connect In Grafana Dashboard
Error kali ini terjadi di dashboard grafana yaitu ketika ingin menambahkan data source di dashboard grafana,ketika klik save dashboard grafana tiba tiba memberika error message yaitu unable to connect dengan warna merah,itu terjadi karena loki masih auth_enabled: true (multi-tenancy), yang mewajibkan header X-Scope-OrgID di tiap request. Kalau gak ada header itu, Loki nolak request dengan error 401, dan Grafana nampilinnya cuma sebagai “Unable to connect”
Solve
Karena root cause sudah ditemukan tinggal solve the problem,hanya perlu command saja dan command itu menghapus multi tenancy dari loki karena ini hanya home lab jadinya tidak di butuhkan gunakan command
helm upgrade loki grafana/loki --namespace monitoring --kubeconfig /home/ubuntu/.kube/config --reuse-values --set loki.auth_enabled=false
Can’t Access Alertmanager Dashboard
Kasusnya sama seperti dashboard grafana karena model infrastructure dari projek yang memliki layer yang kompleks jadinya sulit untuk bisa langsung mengakses dashboard seperti ini karena perlu bypass beberapa layer network terlebih dahulu
Solve
Oke karena root cause nya sama seperti grafana dashboard jadinya solusinya ya sama saja dengan grafana dashboard tinggal melakukan tunneling dan port forward
Di node master
|
kubectl port-forward svc/prometheus-kube-prometheus-alertmanager -n monitoring 9093:9093 &
dan
Di Wsl (butuh password node master)
|
ssh -L 9093:localhost:9093 ubuntu@ip-node-master -N