Scaling the Cluster to Multi-Site and Enforcing RBAC in an Event-Driven Pipeline
Overview
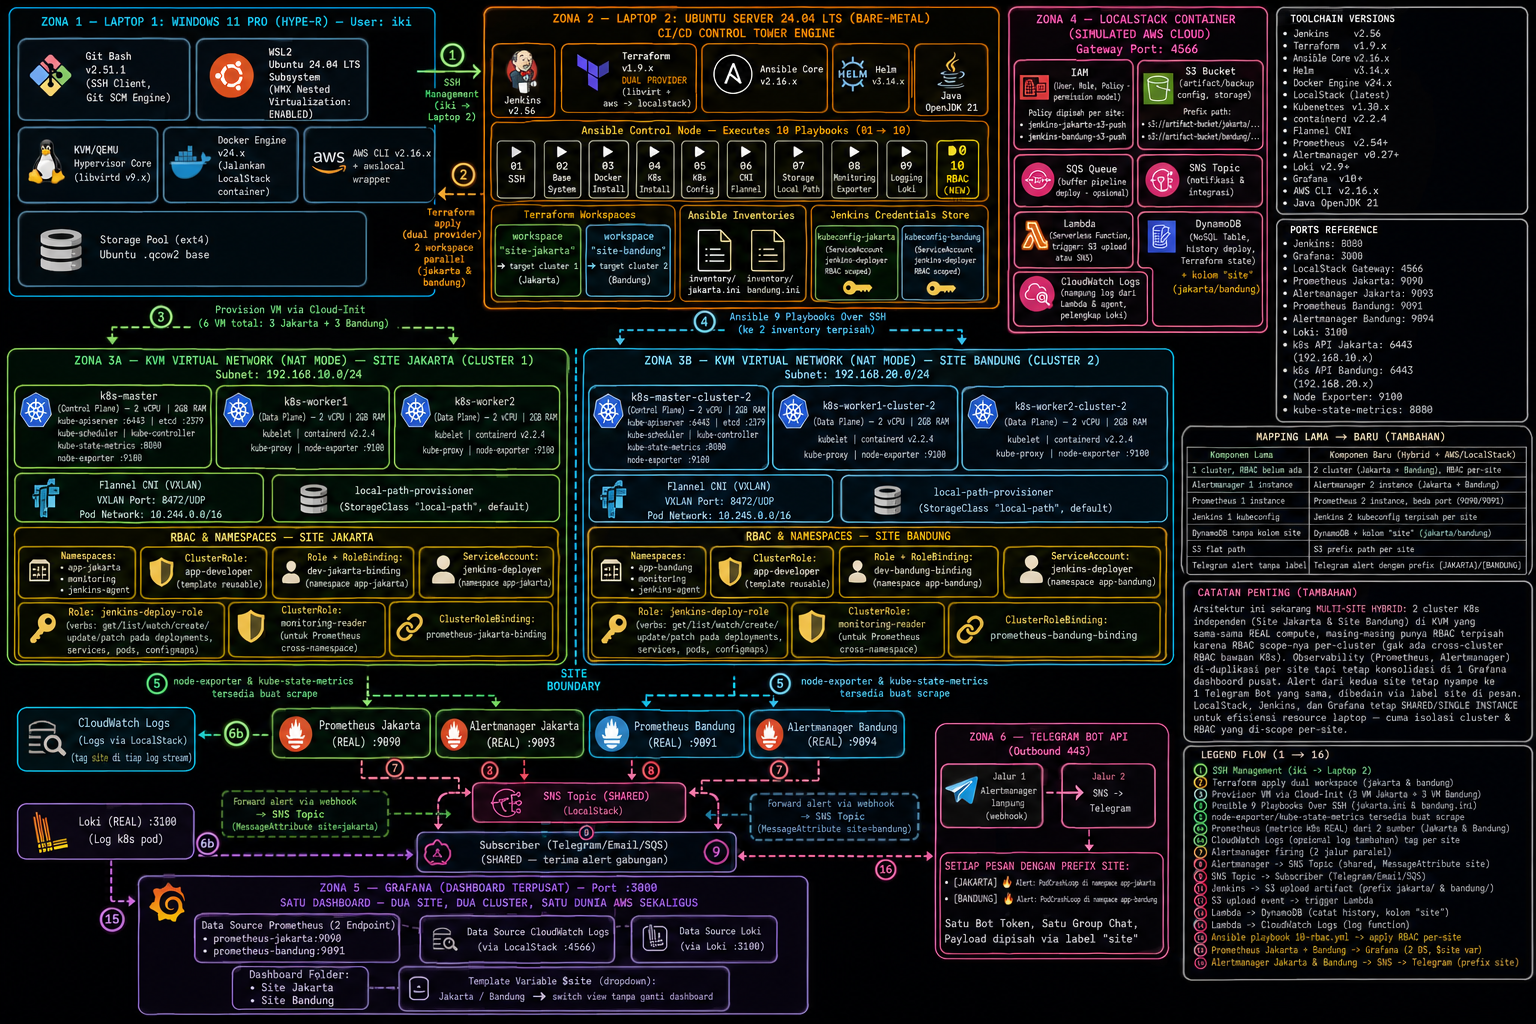
Kali ini saya akan membuat sebuah page baru khusus untuk case atau kasus pada setiap infrastructure yang sudah saya bangun sebelumnya,jadi pada case page ini berisi projek saya yang mengotak-atik infrastructure yang sudah dibangun entah itu menambahkan beban,menambahkan cluster,atau melakukan horizontal scaling atau vertikal scaling, di projek kali ini saya akan menambahkan 1 cluster lagi atau scale cluster yang sudah pernah yaitu “Hybrid Cloud-Native Infrastructure”,dan bukan hanya menambah cluster tapi juga untuk bot telegram di tambahkan sesuai dengan cluster yang ditambah,langsung saja masuk ke pembahasannya
| Node | CPU | RAM | Storage | Network |
|---|---|---|---|---|
| Master-cluster-Jakarta | 2 cores | 2GB | 10GB | 1 Adapters ( Static Ip ) |
| Worker 1-cluster-Jakarta | 2 cores | 2GB | 10GB | 1 Adapters ( Static Ip ) |
| Worker 2-cluster-Jakarta | 2 cores | 2GB | 10GB | 1 Adapters ( Static Ip ) |
| Master-cluster-Bandung | 2 cores | 2GB | 10GB | 1 Adapters ( Static Ip ) |
| Worker 1-cluster-Bandung | 2 cores | 2GB | 10GB | 1 Adapters ( Static Ip ) |
| Worker 2-Cluster-Bandung | 2 cores | 2GB | 10GB | 1 Adapters ( Static Ip ) |
| Jenkins | 7 cores | 7GB | 240GB | Wlan |
STRUCTURE FOLDER
Untuk structure folder yang digunakan dalam projek ini ada tiga yang pertama itu untuk terraform dan yang kedua itu ansible,terakhir itu ada di cluster,
terraform-setup/
├── compute.tf
├── main.tf
├── prep-vm.tf
├── s3.tf
├── sns.tf
├── sqs.tf
├── sqs-trigger-lambda.tf
├── iam-attachment-role.tf
├── iam-attachment-role-consumer.tf
├── lambda_function_consumer.py
├── lambda_function.py
├── lambda-permission.tf
├── lambda.tf
├── lambda-2.tf
├── cloud-watch.tf
├── cloud-watch-metrics.tf
├── dynamodb.tf
├── compute-cluster-2.tf
├── prep-2.tf
lalu yang kedua
k8s/
├── ansible.cfg
├── inventory
├── playbook-allow-port.yaml
├── playbook-ip.yaml
├── playbook-join.yaml
├── playbook-kubernetes.yaml
├── playbook-pkg.yaml
├── playbook-swap.yaml
├── playbook-config.yaml
├── observ.yaml
├── observ_2.yaml
├── service-account.yaml
├── clusterrole.yaml
├── role-binding.yaml
├── secret-token.yaml
├── kubeconfig.sh
dan yang terakhir yang ketiga di cluster
cluster-side/
├── alertmanager-telegram.yaml
Tools
Untuk Tools Masih sama karena ini menggunakan infrastructure yang sudah dibuat sebelumnya jadinya tidak ada perubahan dalam penggunaan tools
Reasoning
Kenapa saya memilih untuk menambahkan cluster? Awalnya saya hanya ingin menerapkan konsep RBAC ke infrastructure yang sudah dibangun. Tapi saya berpikir, untuk 1 cluster saja, penerapan RBAC-nya tidak terlalu menantang — sebatas membuat manifest dan apply ke satu API server. Karena itu saya putuskan untuk sekaligus menambahkan cluster baru, supaya saya juga bisa membuktikan pemahaman bahwa RBAC itu scoped per-cluster — tidak ada RBAC cross-cluster bawaan Kubernetes, jadi config harus dipisah dan diterapkan independen ke masing-masing cluster. Saya pakai blueprint infrastructure yang sama untuk kedua cluster, supaya perbandingan penerapan RBAC-nya konsisten dan environment-nya apple-to-apple.
prerequisites
NOTE!!! BANYAK FILE-FILE CONFIG YANG SAMA DENGAN PROJEK INFRA YANG MENJADI DASAR DAN SEMUA KONDISI HARUS BENAR-BENAR SAMA ENTAH ITU SSH ATAU SETIAP CONFIG Ada beberapa hal sebelum memulai,hal yang perlu di check dan di verfikasi bahwa sudah ada sebelum masuk ke bagian setup
- LAPTOP 2 : Di laptop 2 harus sudah terinstall jenkins(jenkins bertindak full sebagai Ci/Cd) dan terraform
- LOCALSTACK : Localstack sudah harus terinstall di laptop 2
- MANIFEST : Ada banyak file disini seperti .tf , .yaml ,dan file helm jadinya harus sudah ada manifest dari project dasarnya
- WSL : Di wsl yang berjalan di laptop 1 sudah harus terinstall KVM/QEMU
Untuk project dasarnya ada disini link,baca sampai selesai!!! karena keseluruhan proses penting
Setup
NOTE LAKUKAN DI CONTORL TOWER ATAU LAPTOP 2 Sampai pada bagian setup untuk langkah pertama-tama karena dalam case ini akan menambahkan cluster 2 hal yang paling pertama yaitu membuat image untuk cluster baru,karena menggunakan kvm/qemu dan perlu untuk membuat image jadinya langkah pertama dalam case kali ini buat image baru dengan nama node-cluster-2,misal “k8s-worker1-cluster-2” dan di kvm/qemu tidak bisa menggunakan image yang sudah ada dan hanya akan menimbulkan error dan saling tabrakan dengan node yang menggunakan image cluster 1,tapi untuk pool dan volume utama tidak perlu di gandakan,langsung saja lihat masuk ke config
vim prep-cluster-2.tf
|
resource "libvirt_volume" "vm-master-cluster-2" {
  name   = "vm-master-cluster-2.qcow2"
  pool   = libvirt_pool.k8s_pool.name
  target = {
    format = {
      type = "qcow2"
    }
  }


  capacity = 10737418240

  backing_store = {
    path   = libvirt_volume.ubuntu_base.path
    format = {
      type = "qcow2"
    }
  }
}

resource "libvirt_cloudinit_disk" "vm-master-cluster-2" {
  name = "vm-master-cluster-2-spec"

  user_data = <<-EOF
  #cloud-config
  users:
    - name: ubuntu
      sudo: ALL=(ALL) NOPASSWD:ALL
      lock_passwd: false
      shell: /bin/bash
  chpasswd:
    list: |
      ubuntu:iki123
    expire: false
  ssh_pwauth: true
  packages:
    - openssh-server
  timezone: UTC
  EOF

 meta_data = <<-EOF
    instance-id: vm-master-cluster-2
    local-hostname: master-cluster-2
  EOF

  network_config = <<-EOF
    version: 2
    ethernets:
      interfaces:
        match:
          name: enp1s0
        dhcp4: true
  EOF
}

resource "libvirt_volume" "vm-master-cluster-2-cloudinit" {
  name = "vm-master-cluster-2-cloudinit.iso"
  pool = libvirt_pool.k8s_pool.name

  create = {
    content = {
      url = libvirt_cloudinit_disk.vm-master-cluster-2.path
    }
  }
}

resource "libvirt_volume" "vm-worker1-cluster-2" {
  name   = "vm-worker1-cluster-2.qcow2"
  pool   = libvirt_pool.k8s_pool.name
  target = {
    format = {
      type = "qcow2"
    }
  }


  capacity = 10737418240

  backing_store = {
    path   = libvirt_volume.ubuntu_base.path
    format = {
      type = "qcow2"
    }
  }
}


resource "libvirt_cloudinit_disk" "vm-worker1-cluster-2" {
  name = "vm-worker1-cluster-2-spec"

  user_data = <<-EOF
  #cloud-config
  users:
    - name: ubuntu
      sudo: ALL=(ALL) NOPASSWD:ALL
      lock_passwd: false
      shell: /bin/bash
  chpasswd:
    list: |
      ubuntu:iki123
    expire: false
  ssh_pwauth: true
  packages:
    - openssh-server
  timezone: UTC
 EOF

  meta_data = <<-EOF
    instance-id: vm-worker1-cluster-2
    local-hostname: worker-cluster-2
  EOF


  network_config = <<-EOF
    version: 2
    ethernets:
      interfaces:
        match:
          name: enp1s0
        dhcp4: true
  EOF
}

resource "libvirt_volume" "vm-worker1-cluster-2-cloudinit" {
  name = "vm-worker1-cloudinit-cluster-2.iso"
  pool = libvirt_pool.k8s_pool.name


  create = {
    content = {
      url = libvirt_cloudinit_disk.vm-worker1-cluster-2.path
    }
  }
}

resource "libvirt_volume" "vm-worker2-cluster-2" {
  name   = "vm-worker2-cluster-2.qcow2"
  pool   = libvirt_pool.k8s_pool.name
  target = {
    format = {
      type = "qcow2"
    }
  }


  capacity = 10737418240

  backing_store = {
    path   = libvirt_volume.ubuntu_base.path
    format = {
      type = "qcow2"
    }
  }
}

resource "libvirt_cloudinit_disk" "vm-worker2-cluster-2" {
  name = "vm-worker2-cluster-2spec"

  user_data = <<-EOF
  #cloud-config
  users:
    - name: ubuntu
      sudo: ALL=(ALL) NOPASSWD:ALL
      lock_passwd: false
      shell: /bin/bash
  chpasswd:
    list: |
      ubuntu:iki123
    expire: false
  ssh_pwauth: true
  packages:
    - openssh-server
  timezone: UTC
 EOF

  meta_data = <<-EOF
    instance-id: vm-worker2-cluster-2
    local-hostname: worker2-cluster-2
  EOF


  network_config = <<-EOF
    version: 2
    ethernets:
      interfaces:
        match:
          name: enp1s0
        dhcp4: true
  EOF
}

resource "libvirt_volume" "vm-worker2-cluster-2-cloudinit" {
  name = "vm-worker2-cloudinit-cluster-2.iso"
  pool = libvirt_pool.k8s_pool.name


  create = {
    content = {
      url = libvirt_cloudinit_disk.vm-worker2-cluster-2.path
    }
  }
}
diatas adalah contoh dari config pertama dari case ini,dan sebenarnya ini hanya copy paste dari projek Hybrid “Cloud-Native” Infrastructure jadinya hanya copy file prepnya lalu paste dan ganti nama dengan nama node-cluster-2,tapi hanya config image yang di perlukan untuk bagian awal seperti pembuatan pool dan volume yang akan menyimpan image tetap sama,jadinya hanya membuat image tanpa perlu membuat pool dan volume lagi.Masuk ke tahap selanjutnya yaitu computer
vim compute-cluster-2.tf
|
resource "libvirt_domain" "master-cluster-2" {
  name   = "k8s-master-clsuter-2"
  memory = 2097152
  vcpu   = 2
  type   = "kvm"

  os = {
    type         = "hvm"
    type_arch    = "x86_64"
    type_machine = "q35"
  }

  devices = {
    disks = [
      {
        source = {
          volume = {
            pool   = libvirt_pool.k8s_pool.name
            volume = libvirt_volume.vm-master-cluster-2.name
          }
        }
        target = {
          bus = "virtio"
          dev = "vda"
        }
        driver = {
          type = "qcow2"
        }
      },
      {
        device = "cdrom"
        source = {
          volume = {
            pool   = libvirt_pool.k8s_pool.name
            volume = libvirt_volume.vm-master-cluster-2-cloudinit.name
          }
        }
        target = {
          bus = "sata"
          dev = "sda"
        }
      }
    ]

     interfaces = [
      {
        type  = "network"
        model = { type = "virtio" }
        source = {
          network = {
            network = "default"
          }
        }
      }
    ]
  }

  running = true
}

resource "libvirt_domain" "worker1-cluster-2" {
  name   = "k8s-worker1-cluster-2"
  memory = 2097152
  vcpu   = 2
  type   = "kvm"

  os = {
    type         = "hvm"
    type_arch    = "x86_64"
    type_machine = "q35"
  }

  devices = {
    disks = [
      {
        source = {
          volume = {
            pool   = libvirt_pool.k8s_pool.name
            volume = libvirt_volume.vm-worker1-cluster-2.name
          }
        }
        target = {
          bus = "virtio"
          dev = "vda"
        }
        driver = {
          type = "qcow2"
        }
      },
      {
        device = "cdrom"
        source = {
          volume = {
            pool   = libvirt_pool.k8s_pool.name
            volume = libvirt_volume.vm-worker1-cluster-2-cloudinit.name
          }
        }
        target = {
          bus = "sata"
          dev = "sda"
        }
      }
    ]

     interfaces = [
      {
        type  = "network"
        model = { type = "virtio" }
        source = {
          network = {
            network = "default"
          }
        }
      }
    ]
  }

  running = true
}

resource "libvirt_domain" "worker2-cluster-2" {
  name   = "k8s-worker2-cluster-2"
  memory = 2097152
  vcpu   = 2
  type   = "kvm"

  os = {
    type         = "hvm"
    type_arch    = "x86_64"
    type_machine = "q35"
  }

  devices = {
    disks = [
      {
        source = {
          volume = {
            pool   = libvirt_pool.k8s_pool.name
            volume = libvirt_volume.vm-worker2-cluster-2.name
          }
        }
        target = {
          bus = "virtio"
          dev = "vda"
        }
        driver = {
          type = "qcow2"
        }
      },
      {
        device = "cdrom"
        source = {
          volume = {
            pool   = libvirt_pool.k8s_pool.name
            volume = libvirt_volume.vm-worker2-cluster-2-cloudinit.name
          }
        }
        target = {
          bus = "sata"
          dev = "sda"
        }
      }
    ]

     interfaces = [
      {
        type  = "network"
        model = { type = "virtio" }
        source = {
          network = {
            network = "default"
          }
        }
      }
    ]
  }

  running = true
}
masuk ke config kedua yaitu untuk compute atau pembuatan dari node atau domain jika dalam kvm/qemu.tentu saja sama memang cuman copy paste karena hanya membuat node lagi jadinya cuman copy paste config yang sudah ada dan mengganti namanya dengan node-cluster-2,oke jika sudah sekarang coba untuk melakukan apply ohh sebelumnya untuk main.tf atau init masih sama dengan projek infrastructurenya jadi masih mengikuti file main.tfnya,langsung saja
terraform apply
oke jika sudah berhasil cek menggunakan command
virsh list --all
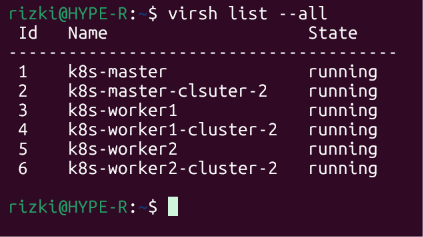
jika sudah output yang diharapkan akan seperti output diatas ada 6 node yang berjalan masing-masing di bagi 3 jadi ada 2 cluster,saya beri nama cluster 2 itu cluster bandung dan untuk cluster 1 cluster jakarta,oke jika sudah maka selamat node sudah berhasil berjalan selanjutnya yaitu bagian installasi k8s di node cluster bandung gampang saja tinggal jalankan ansible playbook yang sama dan hanya menambahkan ip baru ke inventory
vim inventory
|
[Jenkins]
rizky ansible_host=192.168.100.7 ansible_user=rizky ansible_password=iki123

[masters]
k8s-master ansible_host=10.10.10.80 ansible_user=ubuntu ansible_password=iki123

[workers]
k8s-worker1 ansible_host=10.10.10.34 ansible_user=ubuntu ansible_password=iki123
k8s-worker2 ansible_host=10.10.10.35 ansible_user=ubuntu ansible_password=iki123


[masters-cluster-2]
k8s-master-cluster-2 ansible_host=10.10.10.222 ansible_user=ubuntu ansible_password=iki123

[workers-cluster-2]
k8s-worker1-cluster-2 ansible_host=10.10.10.123 ansible_user=ubuntu ansible_password=iki123
k8s-worker2-cluster-2 ansible_host=10.10.10.67 ansible_user=ubuntu ansible_password=iki123
oke jika sudah tinggal tambahkan saja di hosts di bagian atas playbook,semua confignya sama tinggal tambahkan hostnya lalu run,jika sudah install cni untuk network k8s
kubectl apply -f https://github.com/flannel-io/flannel/releases/latest/download/kube-flannel.yml
lalu simpan kubeconfignya
mkdir -p $HOME/.kube
sudo cp -i /etc/kubernetes/admin.conf $HOME/.kube/config
sudo chown $(id -u):$(id -g) $HOME/.kube/config
oke sekarang test apakah berhasil
kubectl get nodes
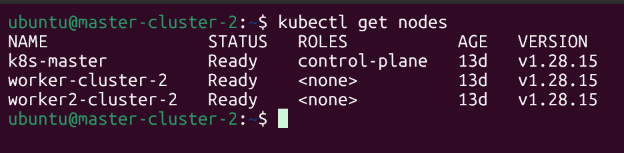
oke sudah berjalan clusternya,lanjut ke tahap berikutnya yaitu pembuatan bot tele,tidak usah berlama-lama lagi caranya masih sama seperti di projke Hybrid Aws Infrastrcuture,baca terlebih dahulu lalu balik lagi kesini,okee jika sudah mendapatkan bot tokennya saya harap ada dua bot token tambahan jadi nantinya ada 4 bot yang aktif 2 bot alert dan 2 bot aws lambda kenapa saya menggunakan 4 bot? karena memang perlu untuk mengtahui secara detail dan eksplisit tentang log,data,trace dari setiap aktifitas atau node yang berjalan jadinya sangat penting jika ingin mementingkan aspek detail dan jika saja ada 1 bot dan bot itu terkena masalah seperti rate limit atau apapun yang bisa menyebabkan workflow terhenti karena 1 bot bermasalah saya masih punya yang bot lainnya,jangan lupa untu buat dua bot telegram untuk site bandung jadinys satu untuk alert dan satu lagi bot aws itu untuk site bandung lalu ada tambahan bot lagi untuk rename bot aws site jakarta yang lama jadi pastikan buat tiga bot 2 bot bandung dan 1 bot pengganti buat bot aws site jakarta karena namanya harus ganti ,jika sudah dapat bot buat alert untuk cluster site bandung masukkan bot token dan chat id dari bot tersebut
vim alertmanager-telegram.yaml
|
alertmanager:
  config:
    global:
      resolve_timeout: 5m
    route:
      receiver: 'telegram-notif'
      group_by: ['alertname']
      group_wait: 30s
      group_interval: 5m
      repeat_interval: 12h
      routes:
        - matchers:
            - alertname = "Watchdog"
          receiver: 'null'
    receivers:
      - name: 'null'
      - name: 'telegram-notif'
        telegram_configs:
          - bot_token: 'BOT-TOKEN'
            chat_id: 1854226173
            parse_mode: 'HTML'
            send_resolved: true
oke jika sudah sekarang update menggunakan helm command edit lagi file terraform.tfvarsnya tapi tambahkan dulu repository dari prometheus
helm repo add prometheus-community https://prometheus-community.github.io/helm-charts
helm repo update
oke jika sudah update menggunakan helm command
helm upgrade prometheus prometheus-community/kube-prometheus-stack --namespace monitoring --kubeconfig /home/ubuntu/.kube/config --reuse-values -f alertmanager-telegram.yaml
oke satu bot untuk alert manager cluster bandung sudah tinggal dua bot untuk aws dua site bandung dan jakartamasukan bot token ke filenya
telegram_bot_token_site_jakarta = "YOUR_BOT_TOKEN"
telegram_chat_id_jakarta   = "1854226173"

telegram_bot_token_site_bandung = "YOUR_BOT_TOKEN"
telegram_chat_id_bandung   = "1854226173"
setelah itu langsung saja edit untuk bagian lambda consumer
vim lambda_function_consumer.py
|
import json
import time
import os
import urllib.request
import urllib.error
import boto3

dynamodb = boto3.resource('dynamodb')
TABLE_NAME = "PipelineHistory"
table = dynamodb.Table(TABLE_NAME)


BOT_CONFIG = {
    "jakarta": {
        "token": os.environ.get("TELEGRAM_BOT_TOKEN_JAKARTA"),
        "chat_id": os.environ.get("TELEGRAM_CHAT_ID_JAKARTA"),
    },
    "bandung": {
        "token": os.environ.get("TELEGRAM_BOT_TOKEN_BANDUNG"),
        "chat_id": os.environ.get("TELEGRAM_CHAT_ID_BANDUNG"),
    },
}


def detect_site(body, original_message):
    try:
        attrs = body.get('MessageAttributes', {})
        site_attr = attrs.get('site', {}).get('Value')
        if site_attr:
            return site_attr.lower()
    except Exception:
        pass

    text_lower = original_message.lower()
    if "bandung" in text_lower:
        return "bandung"
    if "jakarta" in text_lower:
        return "jakarta"

    return "jakarta"


def send_telegram_alert(site, text):
    config = BOT_CONFIG.get(site)
    if not config:
        print(f"Site '{site}' tidak dikenal, skip alert")
        return

    token = config["token"]
    chat_id = config["chat_id"]

    if not token or not chat_id:
        print(f"Bot token/chat_id untuk site '{site}' belum diset, skip alert")
        return

    url = f"https://api.telegram.org/bot{token}/sendMessage"
    payload = json.dumps({
        "chat_id": chat_id,
        "text": f"[{site.upper()}] {text}"
    }).encode('utf-8')

    req = urllib.request.Request(
        url,
        data=payload,
        headers={"Content-Type": "application/json"},
        method="POST"
    )
    try:
        with urllib.request.urlopen(req, timeout=8) as response:
            print(f"Telegram alert ({site}) terkirim, status: {response.status}")
    except urllib.error.HTTPError as e:
        print(f"Telegram API error ({site}): {e.code} - {e.read().decode('utf-8')}")
    except urllib.error.URLError as e:
        print(f"Gagal konek ke Telegram API ({site}): {str(e)}")


def lambda_handler(event, context):
    print(f"RAW EVENT: {json.dumps(event)}")

    for record in event['Records']:
        body = json.loads(record['body'])
        original_message = body.get('Message', 'Pesan tidak ditemukan')
        sns_message_id = body.get('MessageId', record.get('messageId', 'unknown'))

        site = detect_site(body, original_message)
        print(f"Pesan diterima dari SQS (site: {site}): {original_message}")

        item = {
            'event_id': sns_message_id,
            'timestamp': int(time.time() * 1000),
            'message': original_message,
            'source': 'sqs-consumer-lambda',
            'site': site,
            'status': 'processed',
        }

        try:
            table.put_item(Item=item)
            print(f"Berhasil ditulis ke DynamoDB: {item['event_id']}")
        except Exception as e:
            print(f"GAGAL nulis ke DynamoDB: {str(e)}")
            send_telegram_alert(site, f"GAGAL nulis history ke DynamoDB!\n{original_message}\nError: {str(e)}")
            raise

        send_telegram_alert(site, f"Pipeline event diproses:\n{original_message}")

    return {
        'statusCode': 200,
        'body': json.dumps('Pesan berhasil diproses, dicatat ke DynamoDB, dan alert terkirim')
    }
oke kode lambda diatas menggunakan python dan akan secara otomatis memfilter path /jakarta atau /bandung tergantung kata apa yang nantinya digunakan oleh user,misalkan di jenkinsfile di tulis begini
awslocal s3 cp kube.log s3://my-bucket/AWSLogs/jakarta/kube-site-jakarta.log
yang menjadi filter di contoh itu ya kata /jakarta atau /bandung dan jika tidak ada dua kata itu tenang di dalam code ada fallback otomatis yang langsung masuk ke /jakarta bot,saya di bantu claude untuk membbuat lambda codenya hehe :v,oke lanjut edit juga file lambda-2.tf atau config lambdanya
lambda-2.tf
|
resource "aws_lambda_function" "lambda-function-consumer" {
  filename          = "${path.module}/lambda_function_consumer.zip"
  function_name     = "lambda_function_consumer"
  role              = aws_iam_role.lambda-consumer-role.arn
  handler           = "lambda_function_consumer.lambda_handler"
  source_code_hash  = filebase64sha256("${path.module}/lambda_function_consumer.zip")
  runtime           = "python3.12"
  timeout           = 10

  environment {
    variables = {
      TELEGRAM_BOT_TOKEN_JAKARTA = var.telegram_bot_token_site_jakarta
      TELEGRAM_CHAT_ID_JAKARTA   = var.telegram_chat_id_jakarta
      TELEGRAM_BOT_TOKEN_BANDUNG = var.telegram_bot_token_site_bandung
      TELEGRAM_CHAT_ID_BANDUNG   = var.telegram_chat_id_bandung
    }
  }
  tags = {
    Environment = "production"
    Application = "example"
  }
}

variable "telegram_bot_token_site_jakarta" {
  type      = string
  sensitive = true
}

variable "telegram_chat_id_jakarta" {
  type      = string
  sensitive = true
}

variable "telegram_bot_token_site_bandung" {
  type      = string
  sensitive = true
}

variable "telegram_chat_id_bandung" {
  type      = string
  sensitive = true
}
code diatas hanya menambahkan dua variable lagi dan sedikit mengubah nama dari var yang tadinya hanya
TELEGRAM_BOT_TOKEN  = var.telegram_bot_token
TELEGRAM_CHAT_ID    = var.telegram_chat_id
diubah menjadi
TELEGRAM_BOT_TOKEN_JAKARTA = var.telegram_bot_token_site_jakarta
TELEGRAM_CHAT_ID_JAKARTA   = var.telegram_chat_id_jakarta
TELEGRAM_BOT_TOKEN_BANDUNG = var.telegram_bot_token_site_bandung
TELEGRAM_CHAT_ID_BANDUNG   = var.telegram_chat_id_bandung
tidak ada banyak perubahan hanya ada penambahan nama seperti “TOKEN_SITE” dan “CHAT_ID_SITE” kurang lebih sama seperti yang ada di projek infra karena ya memang cuman menambahkan saja hehhehhe,oke jika sudah pastikan hapus file zip lama dari lambda_function_consumer lalu zip ulang
rm lambda_function_consumer.zip
zip lambda_function_consumer.zip lambda_function_consumer.py
oke jika sudah tinggal terraform apply lagi,NOTE KONDISI DISAAT INI SAYA HARAP SEMUA ENVIRONMENT BERJALAN SESUAI DENGAN KONDISI DI PROJEK INFRASTRUCTURE JADINYA TINGGAL RUNNING LAGI ATAU APPLY LAGI SAJA TAPI JIKA BELUM DISAAT IN DOCKER HARUS SUDAH BERJALAN KEMBALI KE PROJEK INFRASTRUCTURE UNTUK MELIHAT BAGAIMANA CARA RUNNING DOCKER LOCALSTACK
terraform apply
oke jika sudah selesai saatnya test manual untuk test manualnya cukup dengan menggunakan command
awslocal s3 cp kube.log s3://my-tf-test-bucket/AWSLogs/bandung/kube-bandung.log
oke tunggu hingga selesai jika command berhasil terkeskusi cek secara berkalan notifikasi di handphone akan ada pesan dari telegram
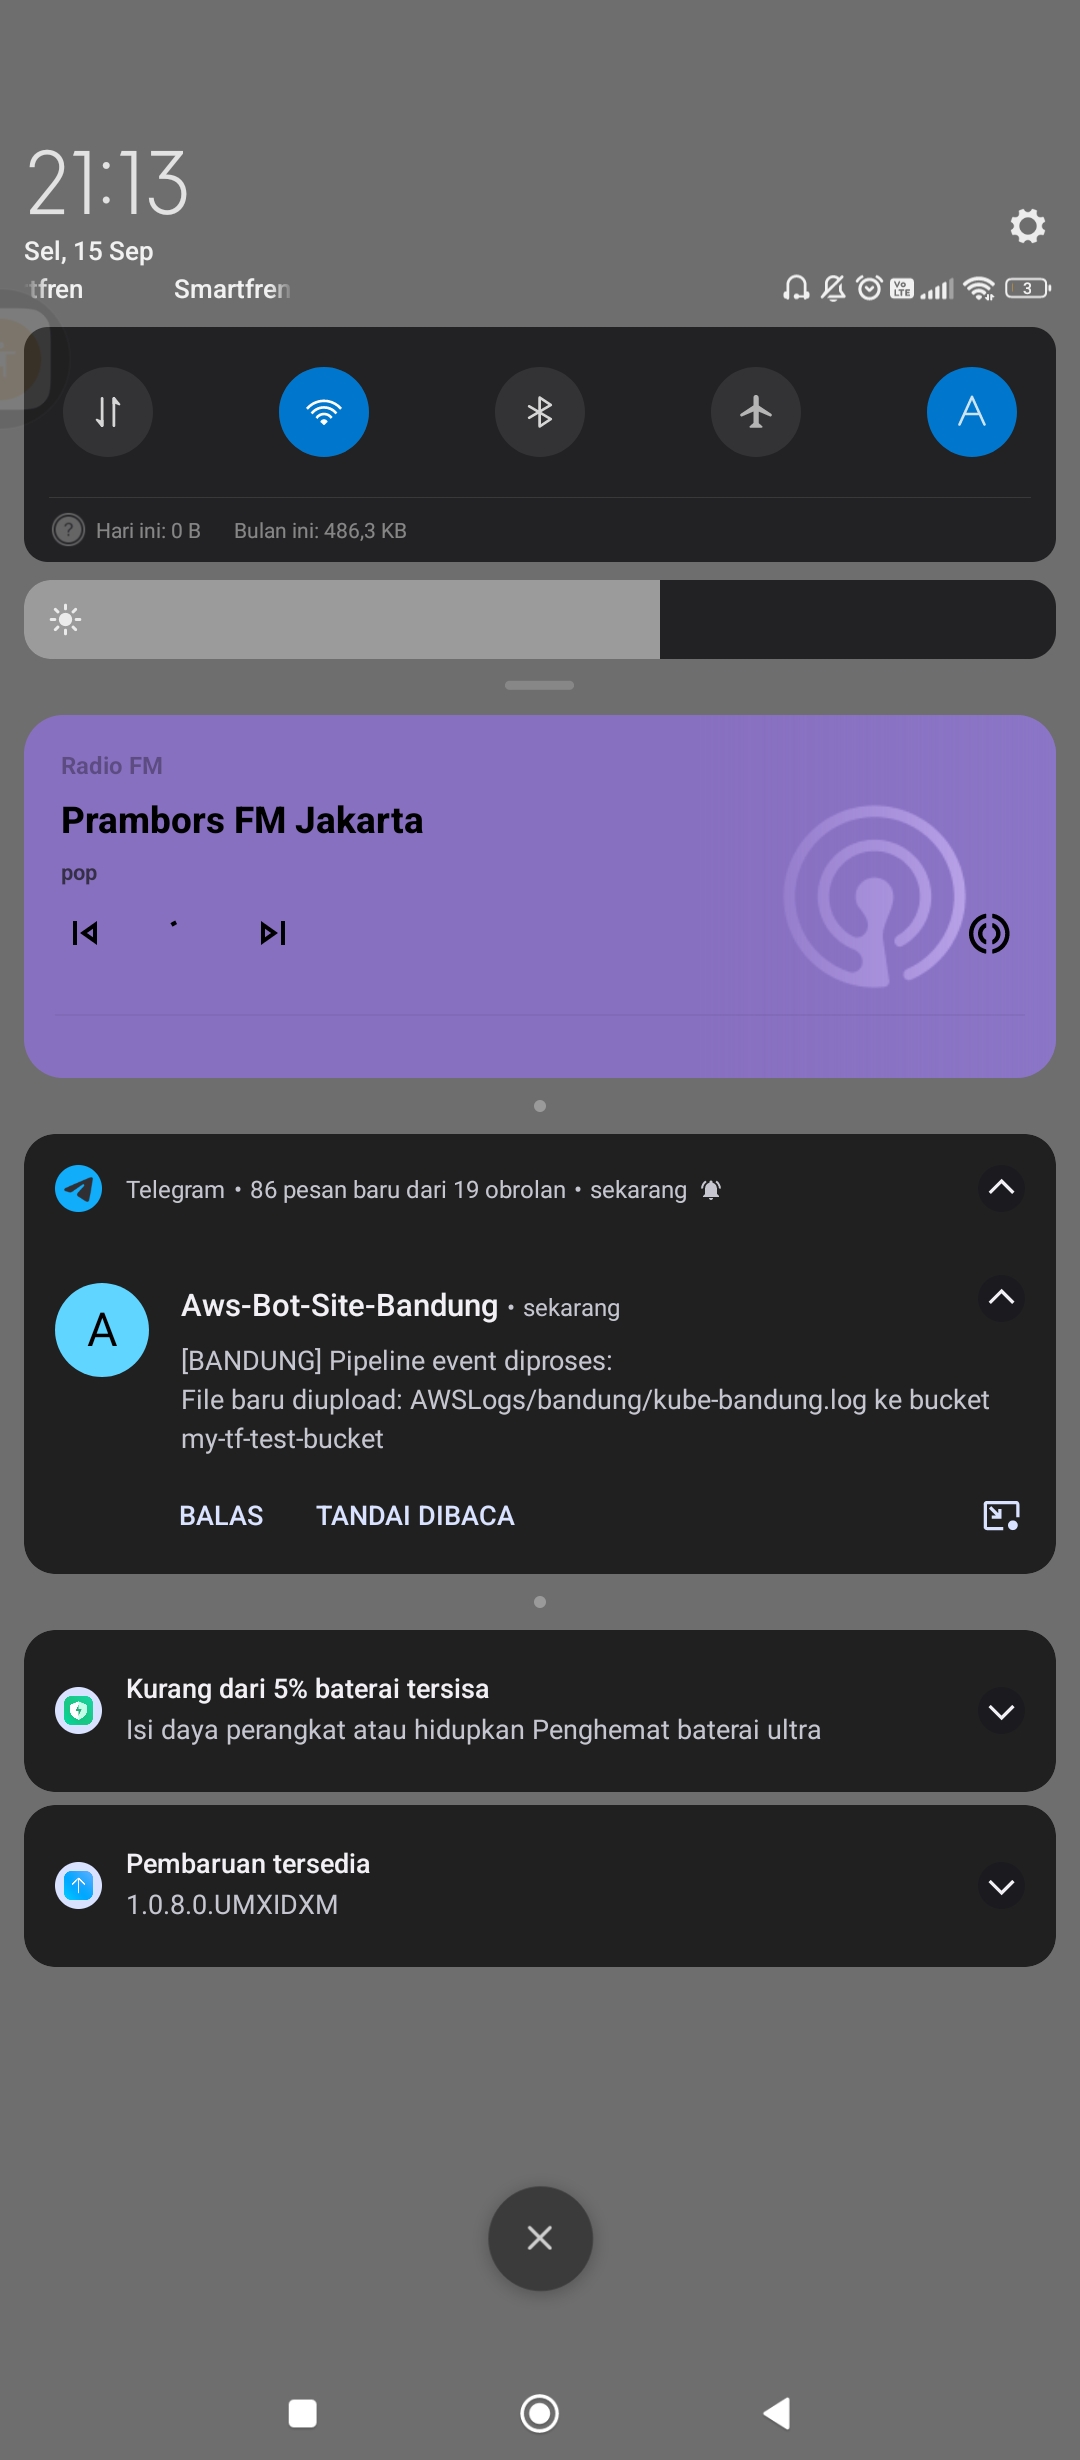
NOTE LAKUKAN STEP INI DI KEDUA CLUSTER JAKARTA DAN BANDUNG oke karena sudah ada notifikasi dari telegram artinya workflownya berjalan dengan baik,oke masuk ke tahap selanjutnya yaitu rbac,untuk bagian rbacnya dimulai dengan pembuatan namespace dari masing-masing cluster
kubectl create namespace app-site
|
kubectl create namespcae app-jakarta (cluster jakarta)
kubectl create namespace app-bandung (cluster bandung)
jika sudah masuk ke bagian config pertama yaitu config service account
vim service-account.yaml
|
apiVersion: v1
kind: ServiceAccount
metadata:
  name: jenkins-deployer
  namespace: app-$site
untuk bagian config service account dengan nama jenkins-deployer dan dengan namespace masing-masing cluster jadi misalkan untuk cluster jakarta tinggal ganti namanya saja di ujung jadi
namespace: app-jakarta
begitu pula dengan cluster bandung,oke jika sudah run file dengan menggunakan command
kubectl apply -f service-account.yaml
oke jika sudah masuk ke config selanjutnya yaitu pembuatan dari clusterrole,oke saya disini akan menggunakan clusterrole kenapa clusterrole? supaya scopednya bisa reach cluster level,kenapa engga role biasa karena role biasa tidak bisa reach scoped cluster jadinya hanya bisa menjangkan namespace saja,lalu untuk binding sedikit berbeda biasanya jika menggunakan clusterrole maka untuk binding akan menggunakan clusterrole binding,kenapa saya menggunakan rolebinding? karena untu lebih mudah mengatuh scopednya jadinya untuk permission yang di berikan itu tidak namespace scoped tapi cluster scoped dan untuk bindingnya hanya namespace scoped,oke langsung saja tanpa
vim clusterrole.yaml
|
apiVersion: rbac.authorization.k8s.io/v1
kind: ClusterRole
metadata:
  name: jenkins-deployler-role
rules:
- apiGroups: ["","apps"]
  resources: ["secrets","services","pods","deployments"]
  verbs: ["get", "watch", "list","get", "watch", "create", "update", "patch", "delete"]
disini saua menggunakn rules untuk apps dan generals dengan memberikan beberapa resource sperti akses ke secrets,services,pods,dan deployments, saya tidak memberikan akses ke nodes karena sensitive,lalu untuk verbs ya standar saja seperti get,delete,update,create,dll jika sudh gunakan command aapply
kubectl apply -f clusterrole.yaml
lanjut ke rolebinding.yaml
vim role-binding.yaml
|
apiVersion: rbac.authorization.k8s.io/v1
kind: RoleBinding
metadata:
  name: jenkins-role-binding
  namespace: app-jakarta
subjects:
- kind: ServiceAccount
  name: jenkins-deployer
  namespace: app-jakarta
roleRef:
  kind: ClusterRole
  name: jenkins-deployler-role
  apiGroup: rbac.authorization.k8s.io
tidak ada banyak hal yang akan saya beritahu soalnya saya sudah memberitahu di awal bahwa saya menggunakan role binding bukan clusterrole binding,jika sudah langsung apply
kubectl apply -f role-binding.yaml
jika sudah dengan role binding berarti sudah ada 4 bot,2 bot alertmanager dan 2 bot aws,tadi sudah buat 3 bot masing masing 2 bot cluster bandung,1 buat alert 1 lagi buat bot aws dan yang terakhir itu buat bot aws site jakarta karena harus rename yang lama namanya pelir_kejepit,oke yang diharapkan itu seperti yang tadi sudah di sebutkan lalu masuk ke bagian selanjutnya yaitu membuat secret token untuk kubeconfig,kenapa harus pakai kubeconfig padahal tinggal generate bisa kan pakai imperative atau command manual,masalahnya jika menggunakan command manual atau imperativ itu ada kekurangannnya seperti nanti token akan expired dan tidak bisa digunakan lagi,oke masuk saja ke file confignya
vim secret-token.yaml
|
apiVersion: v1
kind: Secret
metadata:
  name: jenkins-deployer-token
  namespace: app-$site
  annotations:
    kubernetes.io/service-account.name: jenkins-deployer
type: kubernetes.io/service-account-token
oke pertama-tama buat secret terlebih dahulu karena nantinya token akan di simpan di sebuah secret,di secret hanya berisi hal-hal yang sudah di buat sebelumnya seperti namespace lalu ada service account,llau jika sudah masuk ke bagian selanjutnya yaitu apply config
kubectl apply -f secret-token.yaml
jika sudah ambil token dari secret yang sudah di buat
kubectl get secret jenkins-deployer-token -n app-jakarta -o yaml
kurang lebih akan terlihat seperti ini
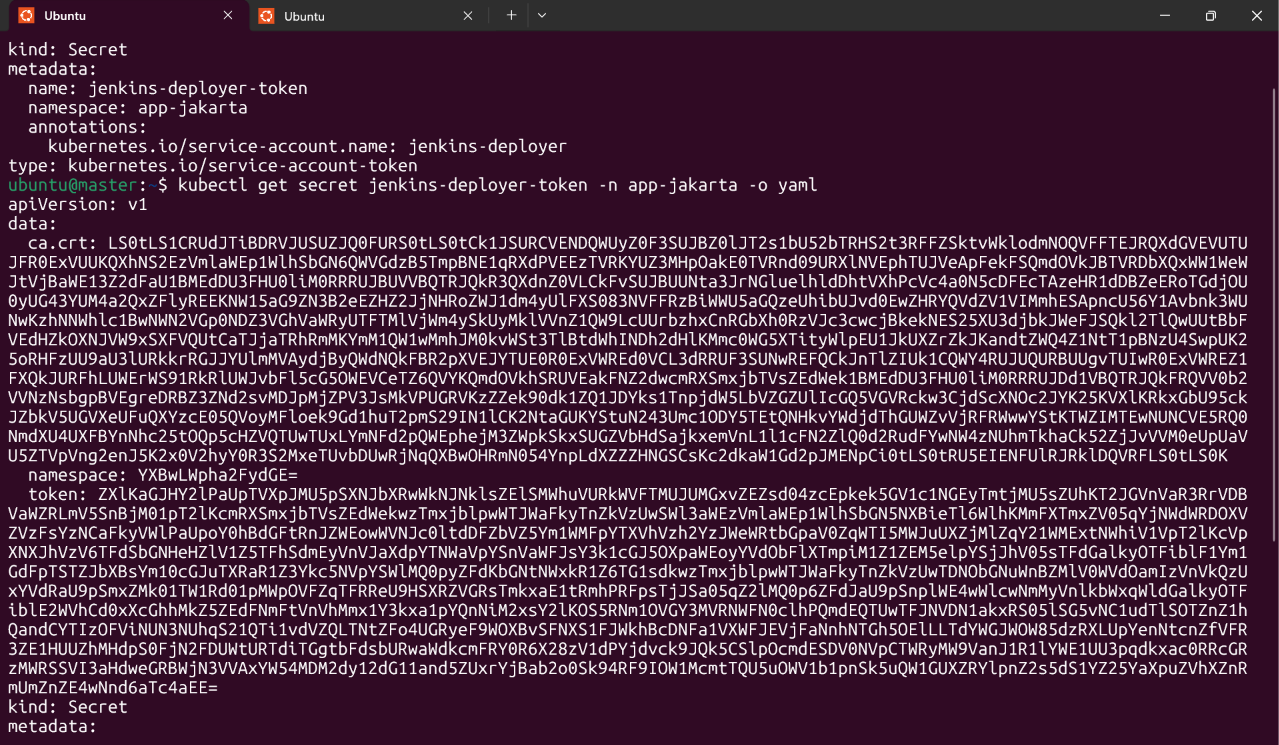
oke jika sudah ambil isi dari token lalu jadikan sebuah variable
TOKEN=$(kubectl get secret jenkins-deployer-token -n app-jakarta -o jsonpath='{.data.token}' | base64 -d)
CA_CERT=$(kubectl get secret jenkins-deployer-token -n app-jakarta -o jsonpath='{.data.ca\.crt}')
SERVER=$(kubectl config view --minify -o jsonpath='{.clusters[0].cluster.server}')
setelah itu masuk kebagian vital dari step ini yaitu masuk ke file bash untuk generate kubeconfig,variable tadi akan digunakan didalam bash script ini
kubeconfig.sh
|
#!/bin/bash
set -euo pipefail

NAMESPACE="app-$site"
SA_NAME="jenkins-deployer"
SECRET_NAME="jenkins-deployer-token"
CLUSTER_NAME="$site-cluster"
CONTEXT_NAME="jenkins-$site-context"

SERVER="https://127.0.0.1:6443"

OUTPUT_FILE="kubeconfig-$site.yaml"

TOKEN=$(kubectl get secret "$SECRET_NAME" -n "$NAMESPACE" -o jsonpath='{.data.token}' | base64 -d)
CA_CERT=$(kubectl get secret "$SECRET_NAME" -n "$NAMESPACE" -o jsonpath='{.data.ca\.crt}')

if [[ -z "$TOKEN" || -z "$CA_CERT" ]]; then
  echo "ERROR: token atau ca.crt masih kosong. Cek Secret-nya dulu, mungkin controller belum selesai isi."
  exit 1
fi

cat <<EOF > "$OUTPUT_FILE"
apiVersion: v1
kind: Config
clusters:
- name: ${CLUSTER_NAME}
  cluster:
    certificate-authority-data: ${CA_CERT}
    server: ${SERVER}
contexts:
- name: ${CONTEXT_NAME}
  context:
    cluster: ${CLUSTER_NAME}
    namespace: ${NAMESPACE}
    user: ${SA_NAME}
current-context: ${CONTEXT_NAME}
users:
- name: ${SA_NAME}
  user:
    token: ${TOKEN}
EOF

chmod 600 "$OUTPUT_FILE"
echo "Kubeconfig berhasil dibuat: $OUTPUT_FILE"
NOTEEEE!!! UNTUK KUBECONFIG BANDUNG HARUS ADA DUA JADINYA CP OUTPUT FILE DARI BASH SCRIPT YANG SATU DENGAN PORT 6444 & SATUNYA LAGI 6443,KENAPA HARUS DUA KARENA DI WSL NANTINYA UNTUK MELAKUKAN APPLY MENGGUNAKN KUBECONFIG TERSEBUH HARUS DI SERTAI DENGAN SSH ATAU TUNNELING NAH UNTUK TUNNELING KE PORT 6443 DI WSL SUDAH ADA CLUSTER JAKARTA DAN UNTUK CLUSTER BANDUNG ADA DI 644.JADINYA CONFIG YANG DI PAKAI DI DASHBOARD JENKINS ITU YANG 6444 SEMENTARA UNTUK TESTING MANUAL MENGGUNAKAN 6443
saya minta claude untuk generate code bash ini bisa dilihat akan menggenerate kubeconfig yang mengambil nilai dari variable yang sudah di set sebelumnya dan tentu harus tergantung dengan site mana yang akan di generate misalkan di jakarta ya tinggal ganti dengan nama site jakarta,setelah berhasil di generate akan menredirect atau mengarahkan output ke sebuah file bernama kubeconfig-$site-cluster.yaml,jika sudah tinggal run saja file nya tapi sebelum itu
chmod +x kubeconfig.sh
lalu tinggal
./kubeconfig.sh
oke jika sudah coba sekarang test untuk kubeconfig nya apakah sudah berhasill atau tidak,dengan menggunakan command
KUBECONFIG=./kubeconfig-$site.yaml
jika output seperti dibawah ini

maka selamat kubeconfig sudah berjalan lakukan hal yang sama di step pembuatan dari file script ganti sesuai dengan cluster,jika sudah maka seharusnya akan ada dua kubeconfig
kubeconfig-jakarta.yaml
kubeconfig-bandung.yaml
setelah itu buat repository terpisah di github terserah namanya,lalu clone repositorynya disin saya sudah clone ke laptop 2 karena memang saya sudah clone repositorynya sejak lama,lalu cat semua file kubeconfig lalu buat file dengan nama yang sama di laptop 2 didalam repository tentunya lalu push,setelah itu git clone di laptop 1 dan simpan di folder /Documents,lanjut ke tahap selanjutnya yaitu installasi plugin kub cli di jenkins
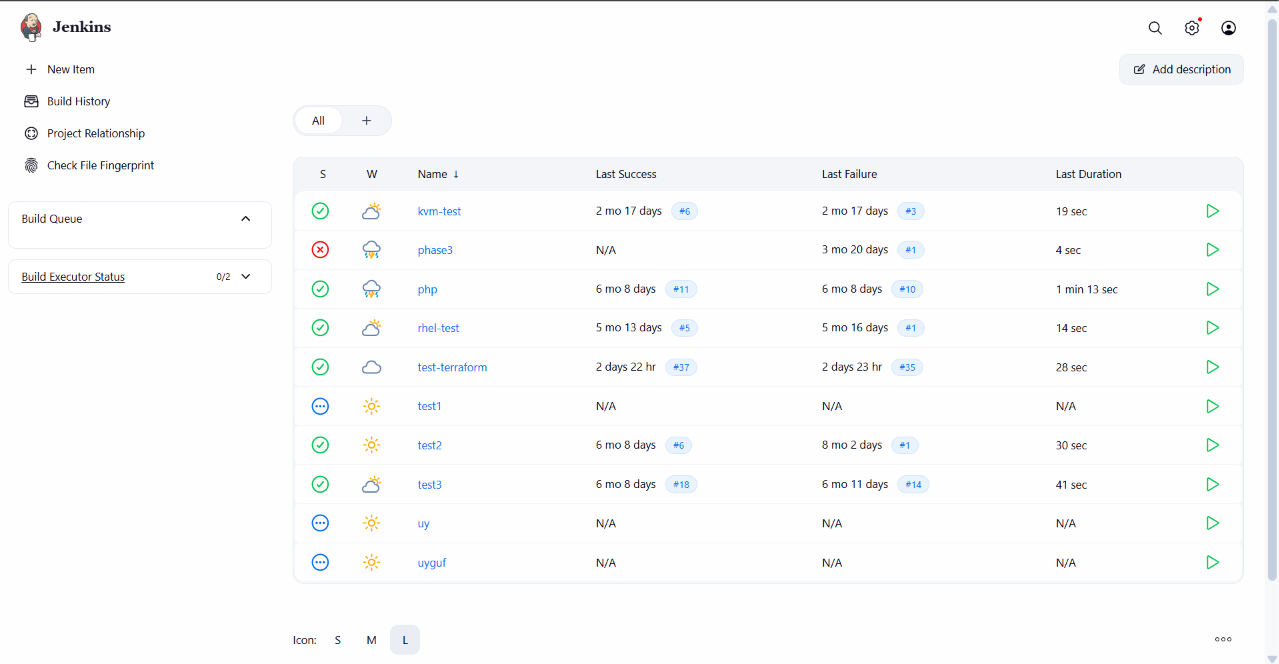
pertama-tama masuk ke jenkins di browser terlebih dahulu,kenapa tidak masuk ke browser laptop 2? karena laptop 2 itu bener bener ngelag jadinya masuk ke firefox aja ga bisa jadinya untuk akses dashboard jenkins harus lewat browser laptop 1 maka dari itu saya push ke repo lalu clone reponya lagi di laptop 1 karena jika lewat browser di laptop 2 niscaya tidak akan pernah selesai soalnya laptop 2 itu super duper lagggg,oke masuk ke dashboard jenkins sudah lalu klik logo settings di pojok kanan atas,setelah itu cari pluggin
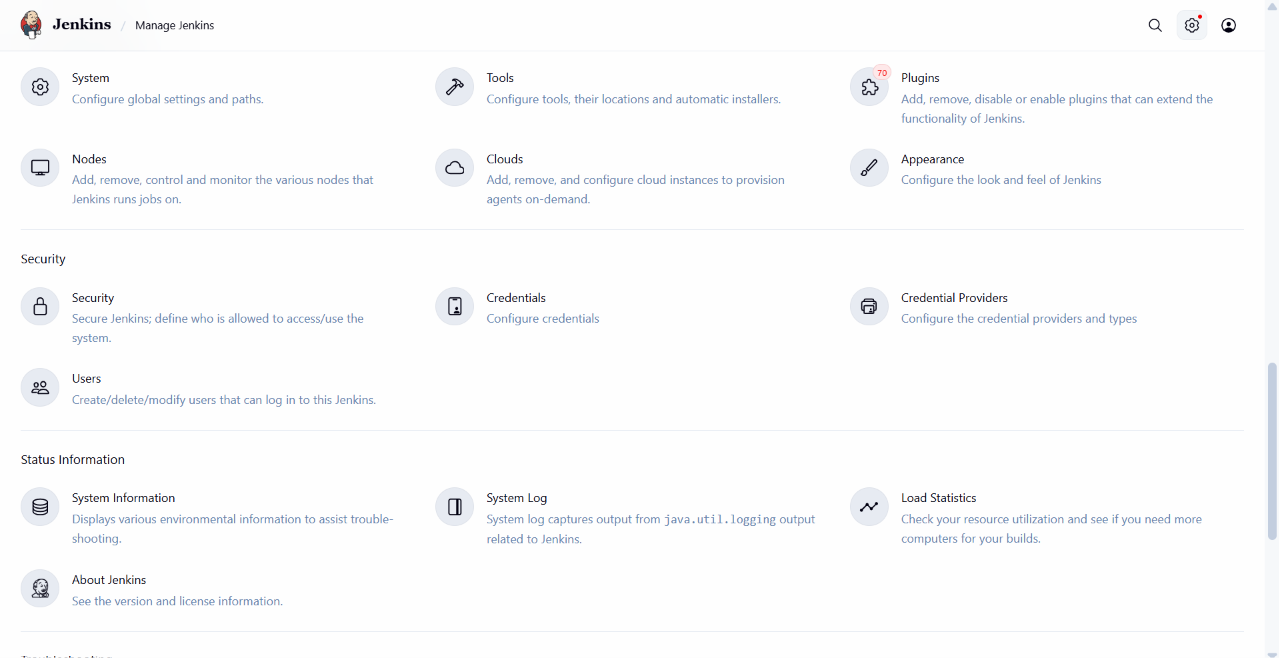
jika sudah scroll kebawah atau gunakan menu pencarian,saya scroll ke bawah lalu cari bagian pluggin seperti diatas,klik bagian pluggin tersebut
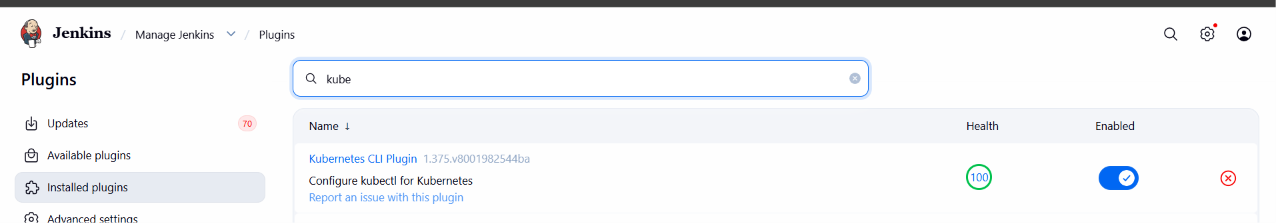
lalu cari bagian avaible pluggins dan cari nama seperti pluggins diatas kenapa saya ada di bagian installed plugins karena saya sudah install pluginsnya,oke jika sudah kembali lagi ke menu settings lalu sekarang cari bagian credentials,jika sudah masuk ke bagian credentials
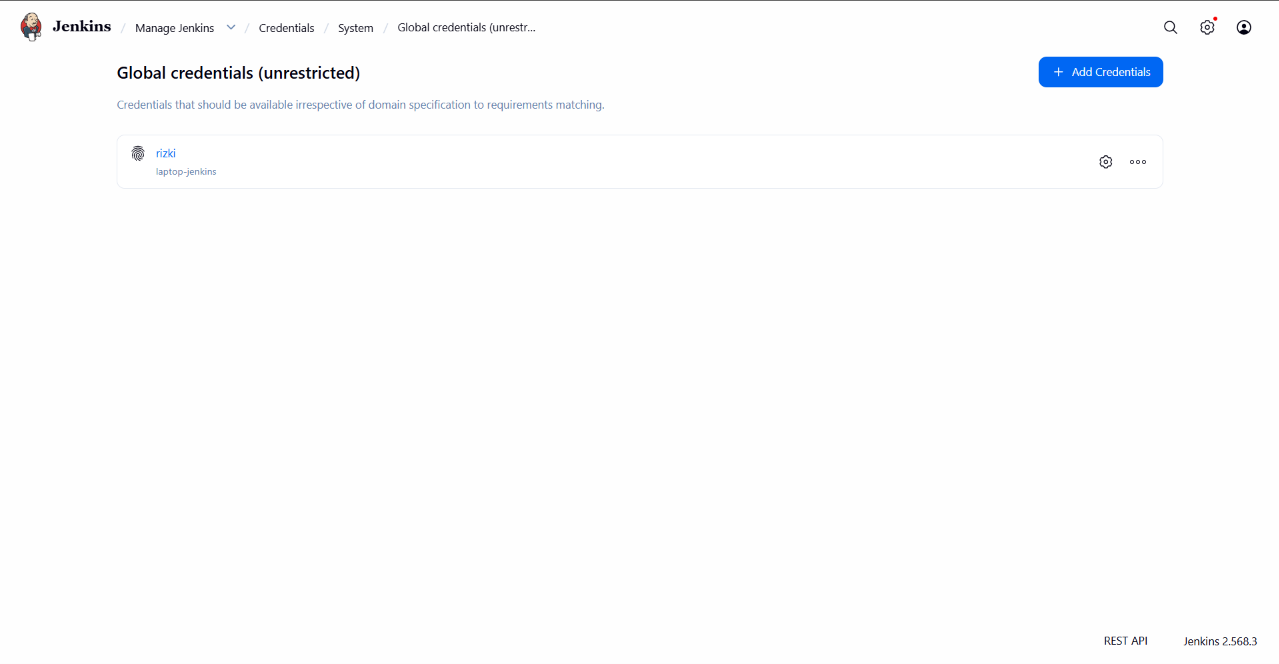
lalu add credentials lalu ganti jenis dari credentialsnya menjadi secret file lalu tambahkan file kubeconfig yang dari repository tadi yang sudah di clone
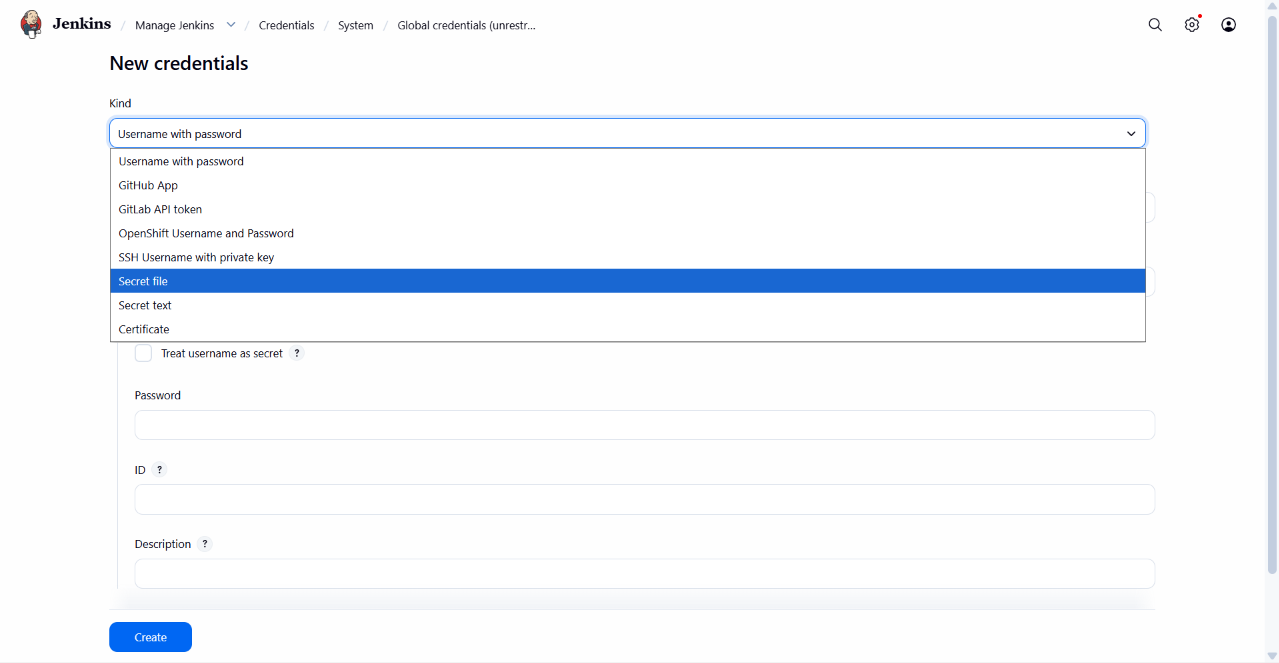
lalu isi id dengan
$site-site
|
jakarta-site
bandung-site
oke jika id dan file sudah ada klik create lalu buat lagi untuk cluster selanjutnya,jika sudah masuk ke terminal laptop 2 lalu masuk lagi ke directory yang sebelumnya sudah di test di projek infra,NOTE INGAT SAYA SUDAH BERKALI-KALI MEMBERITAHU BAHWA SEMUA STATE ATAU KONDISI DISAAT INI ITU SAMA SEPERTI DI PROJEK INFRA JADINYA MULAI DARI NGROK,SSH PROXY JUMP,KONDISI REPOSITORY MASIH BENAR BENAR SAMA DENGAN YANG SEBELUMNYA,jika sudah masuk ke repository lalu buat file html sederhana dengan isi
vim site-jakarta.html
|
<h1>HALO DARI SITE JAKARTA</h1>
jika sudah buat lagi dengan nama site-bandung.html dengan isi yang sama,lalu buat Dockerfile dengan isi base menggunakan nginx,lalu copy setiap file html dengan yang pertama itu site-jakarta.html
FROM nginx:latest

COPY ./site-jakarta.html /usr/share/nginx/html/index.html
lalu buat image dari dockerfile yang sudah di buat
docker build -t rizki736/site-jakarta
lalu push ke repository,jangan lupa ulangin langkah tadi untuk cluster bandung ,lalu edit untuk bagian kube.yaml menjadi seperti ini
cp kube.yaml kube-site-$site.yaml
|
kube-site-jakarta.yaml
kube-site-bandung.yaml
jika sudah masuk ke file pertama
vim kube-site-jakarta.yaml
|
apiVersion: apps/v1
kind: Deployment
metadata:
  name: apps1
  labels:
    apps1: test
  namespace: app-jakarta
spec:
  replicas: 1
  selector:
    matchLabels:
      apps1: test
  template:
    metadata:
      labels:
        apps1: test
    spec:
      containers:
        - name: nginx
          image: rizki736/site-jakarta-image
          ports:
            - containerPort: 80


---
apiVersion: v1
kind: Service
metadata:
  name: apps1-service
  namespace: app-jakarta
spec:
  selector:
    apps1: test
  ports:
    - port: 80
      targetPort: 80
      nodePort: 30000
      protocol: TCP
  type: NodePort
apa yang beda,disni terdapat sedikit perbedaan seperti penambahan namespcae di deployments maupun service lalu image diganti dengan image yang sudah dipush sebelumnya,untuk kube-site- bandung.yaml lakukan hal yang sama tambahkan namespace di deployments maupun di service, lalu edit Jenkinsfile menjadi seperti ini
pipeline {
    agent any
    stages {
        stage('Deploy Site Jakarta') {
            steps {
                withKubeConfig([credentialsId: 'jakarta-site']) {
                    sh 'echo "test dari site cluster jakarta"'
                    sh 'kubectl apply -f kube-site-jakarta.yaml'
                    sh 'kubectl get deployments -n app-jakarta'
                    sh 'awslocal s3 cp kube.log s3://my-tf-test-bucket/AWSLogs/jakarta/kube-jakarta.log'
                }
            }
        }
        stage('Deploy Site Bandung') {
            steps {
                withKubeConfig([credentialsId: 'bandung-site']) {
                    sh 'echo "test dari site cluster bandung"'
                    sh 'kubectl apply -f kube-site-bandung.yaml'
                    sh 'kubectl get deployments -n app-bandung'
                    sh 'awslocal s3 cp kube.log s3://my-tf-test-bucket/AWSLogs/bandung/kube-bandung.log'
                }
            }
        }
    }
}
perbedaan yang ditambahkan sekarang menggunakan withKubeConfig dan variable dari credentials id yang sudah ditulis jadi tidak menggunakan admin.conf dan ini merupakah penerapan konsep rbac,jadinya kini jenkins tidak mengakses menggunakan admin.conf,oke tinggal push ke repository gitlab dengan satu kondisi bahwa semua state atau kondisi environment sama dengan projek infra jadinya harus membaca projek infranya terlebih dahulu
git add .
git commit -m "deploy"
git push origin main
masuk ke dashboard untuk cek secara berkala apakah ada pipeline yang sedang berjalan atau tidak
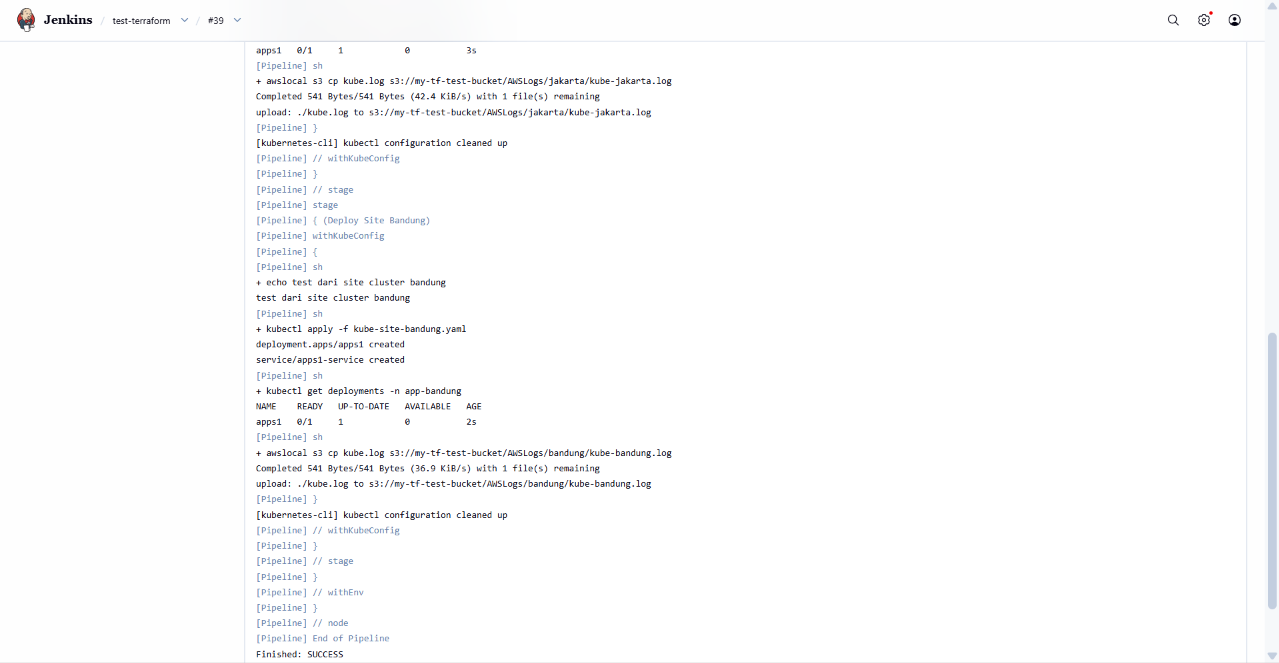
oke dan ternyata berjalan dengan sempurna lalu cek secara berkala untuk bot telegram apakah ada notifikasi dari telegram atau tidak
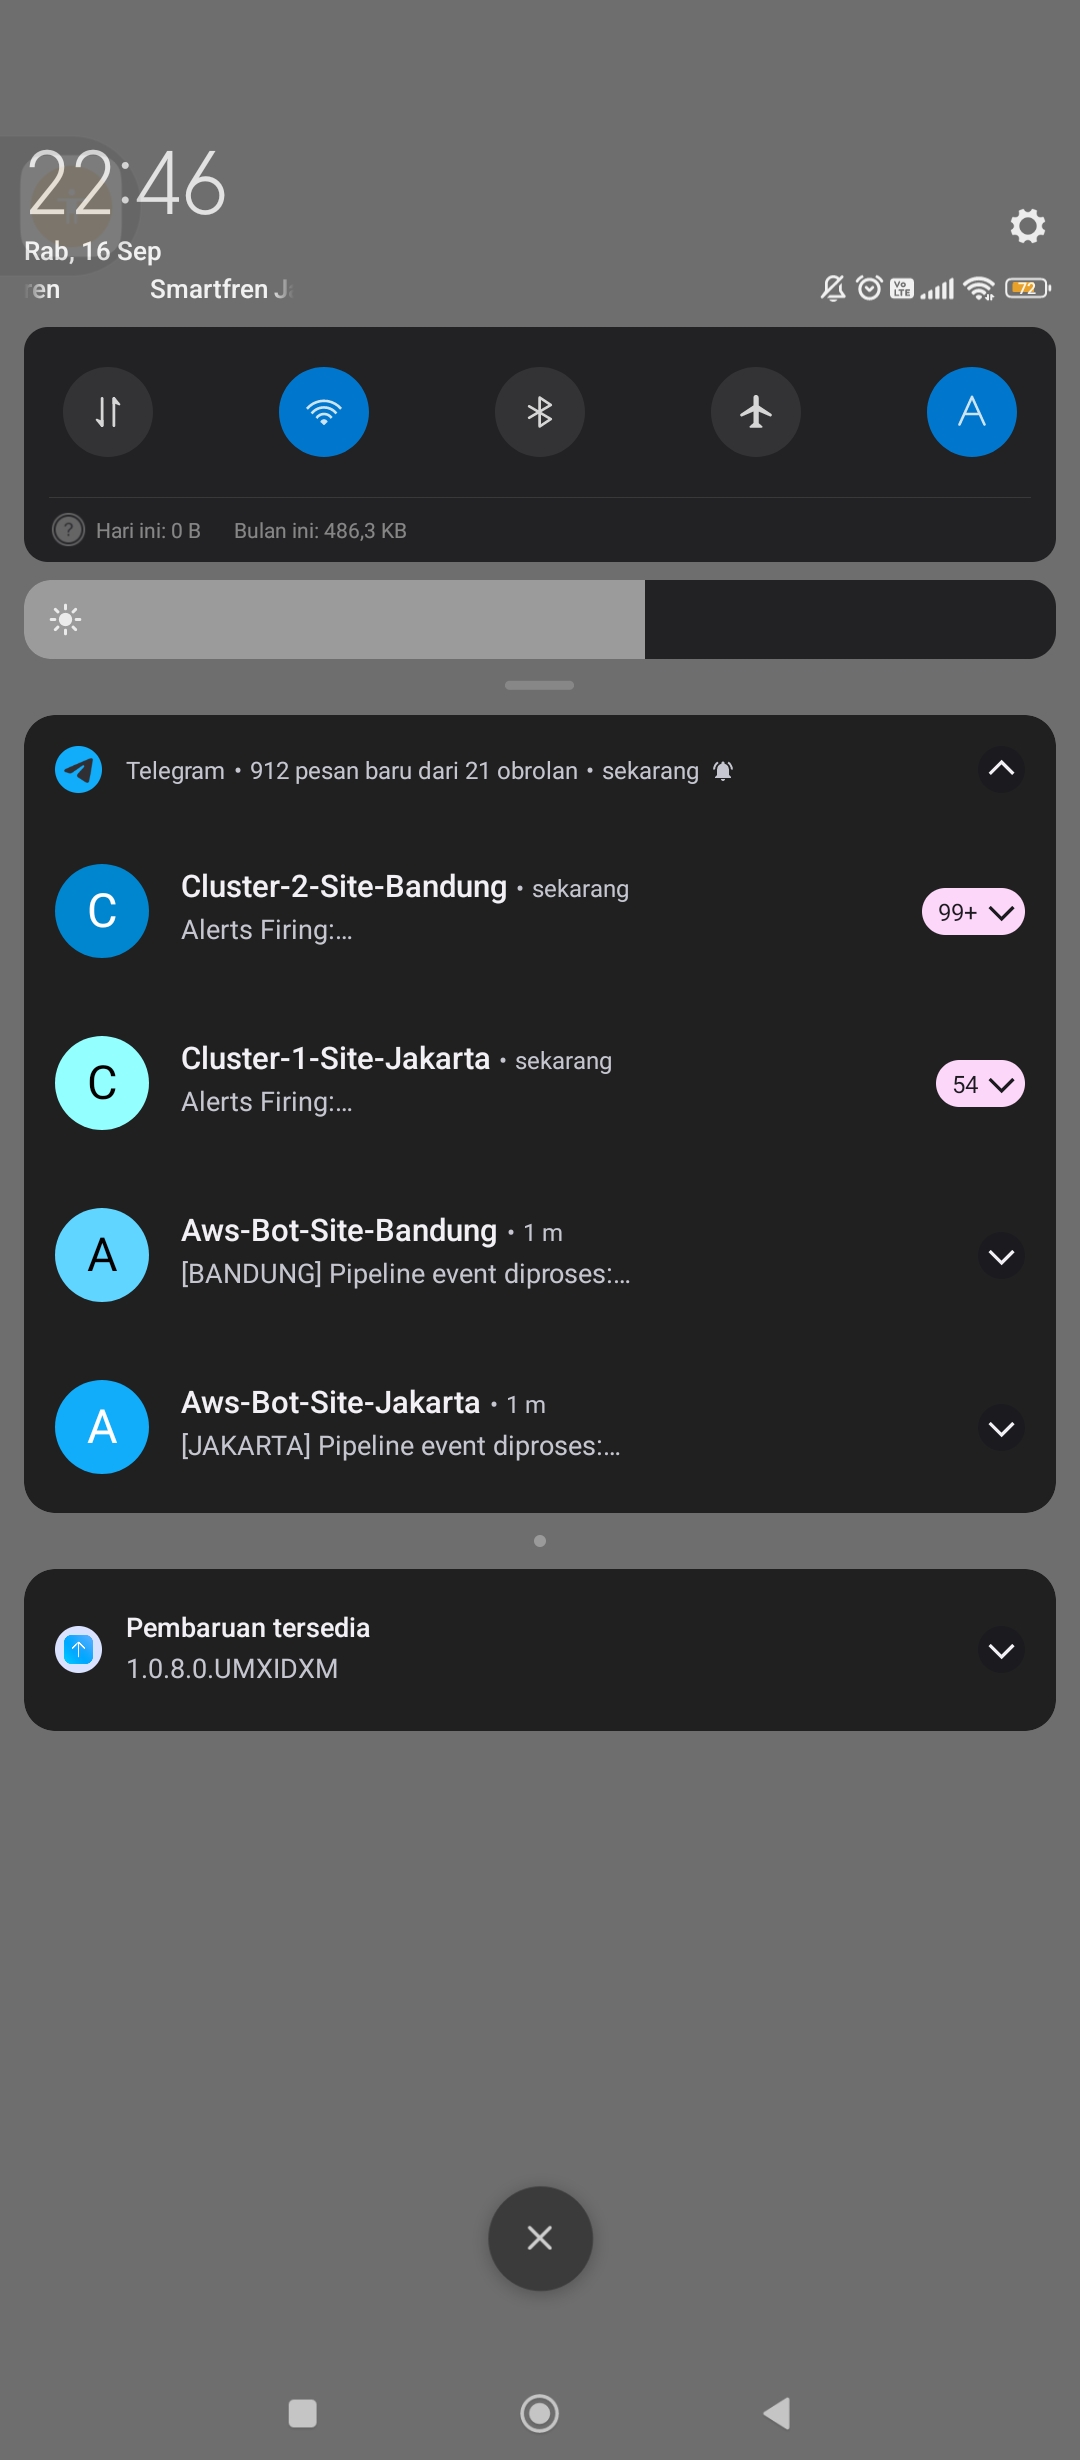
oke masuk ternyata sudah ada notifikasi,lalu jika ingin cek apakah ada untuk deploymentnya bisa gunakan port forward di kubectl dan socat untuk akses pods di browser tinggal gunakan command
LALUKAN DI DUA CLUSTER
di cluster  bisa di cluster jakarta atau bandung bebas (sesuaikan dengan port service di cluster)
|
kubectl port-forward svc/apps1-service 30000:80 -n default --address=0.0.0.0 &
lalu
di wsl (sesuaikan dengan port service di cluster)
|
socat TCP-LISTEN:30000,bind=0.0.0.0,fork TCP:10.10.10.80:30000 -n app-$site &
jika sudah tinggal masuk ke browser lalu akses ke
localhost:30000
localhost:30001
Result
hasilny akan ada dua deployments
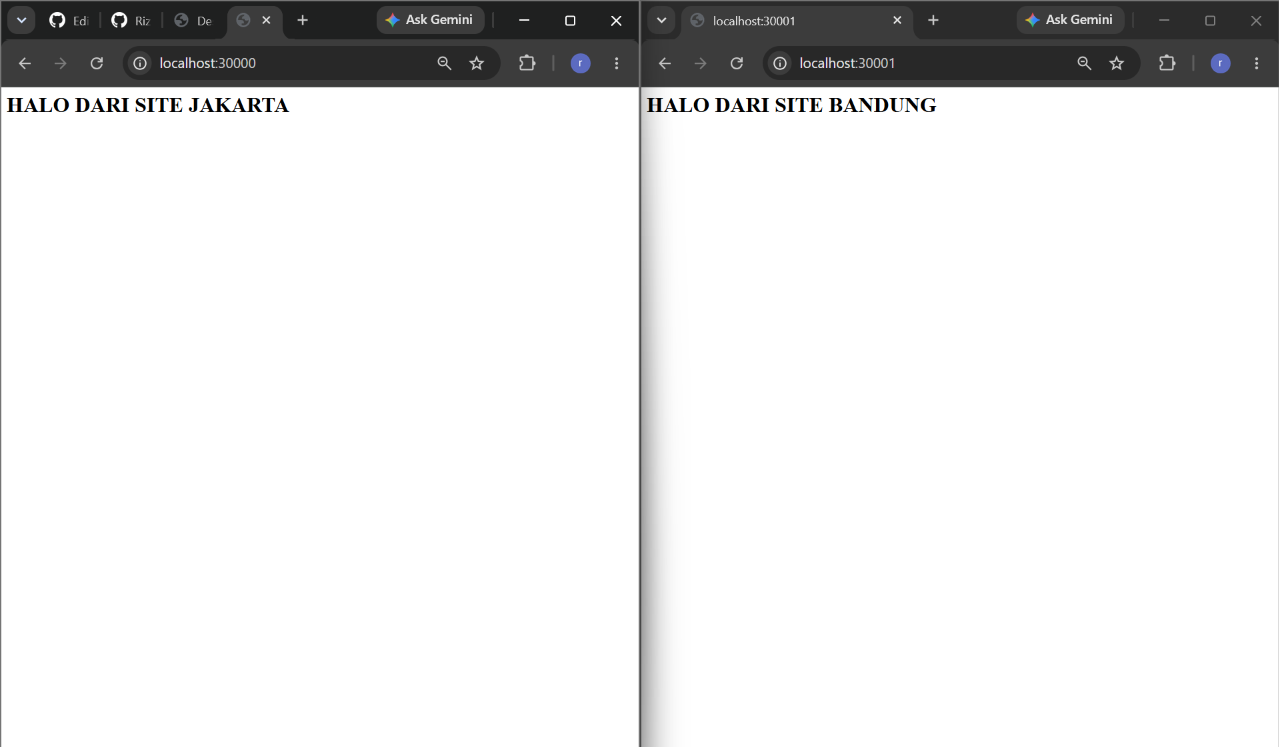
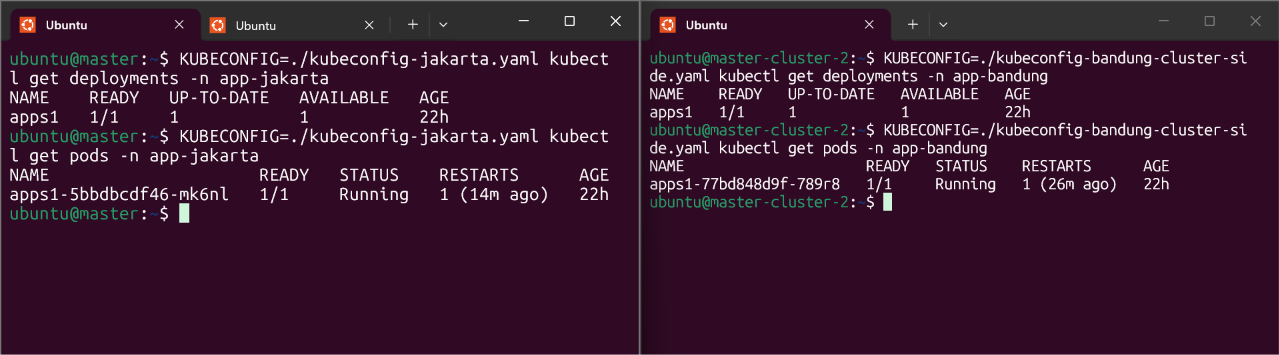
jika sudah sekarang cek untuk bagian deployments di cluster menggunakan command
KUBECONFIG=./kubeconfig-$site.yaml kubectl get deployments -n app-$site
maka hasilnya akan seperti ini
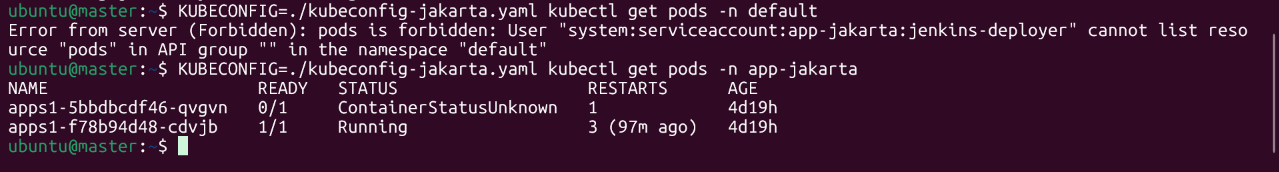
lalu jika mencoba untuk mengakses namespace lain selain dari namepspace yang sudah di set maka akan keluar output seperti ini
baik sudah selesai terimakasih telah menyimak